

Цифровой голос коровы: набор биоакустических данных и ML-платформа для точного животноводства
Слияние технологий Интернета вещей (IoT), периферийных вычислений (edge computing) и машинного обучения производит революцию в точном животноводстве. Тем не менее биоакустические потоки данных по-прежнему используются недостаточно активно из-за высокой вычислительной сложности и проблем с экологической валидностью (соответствием реальным условиям фермы). [1]
Аннотация
Мы представляем один из наиболее полных на сегодняшний день наборов данных вокализации крупного рогатого скота. Он включает 569 отобранных экспертами аудиофрагментов, охватывающих 48 поведенческих классов. Записи были сделаны на трех коммерческих молочных фермах с использованием массивов из нескольких микрофонов и расширены до 2 900 образцов с помощью аугментации данных, учитывающей специфику предметной области.
Этот ресурс, соответствующий принципам FAIR, решает ключевые задачи больших данных (Big Data):
Объем (Volume). 90 часов исходных аудиозаписей общим весом 65,6 ГБ.Разнообразие (Variety). Акустическая среда разных ферм и функциональных зон.Скорость (Velocity). Требования к обработке данных в режиме реального времени. Достоверность (Veracity). Конвейеры извлечения признаков, устойчивые к фоновым шумам.
Модульный рабочий процесс обработки данных объединяет шумоподавление (реализованное в iZotope RX 11 для контроля качества, а также в виде открытого аналога на Python с использованием библиотеки noisereduce), мультимодальную синхронизацию (выравнивание аудио и видео) и стандартизированное конструирование признаков. Для масштабируемого мониторинга благополучия животных извлекаются 24 акустических дескриптора с помощью инструментов Praat, librosa и openSMILE.
Предварительные тесты выявляют четкие акустические паттерны на уровне классов для определения охоты (эструса), классификации дистресса (стресса) и материнской коммуникации. Экологическая реалистичность датасета, отражающая подлинную акустику коровника, а не лабораторные условия, гарантирует его готовность к внедрению на практике.
Данная работа закладывает основу для искусственного интеллекта, ориентированного на животных, где биоакустические потоки обеспечивают непрерывную неинвазивную оценку благополучия в промышленных масштабах. Публикуя соответствующий принципам FAIR набор данных в репозитории Zenodo (с ограниченным доступом) и конвейер предварительной обработки с открытым исходным кодом на GitHub вместе с подробными схемами метаданных, мы способствуем воспроизводимым исследованиям на стыке аналитики больших данных, устойчивого сельского хозяйства и точного животноводства. Фреймворк напрямую поддерживает Цель устойчивого развития ООН № 9 (ЦУР 9), демонстрируя, как наука о данных может трансформировать традиционное фермерство в интеллектуальные производственные системы, оптимизированные под благополучие животных и способные удовлетворить глобальный спрос на продовольствие при соблюдении этических стандартов ухода за скотом.
1 Введение
Экспоненциальный рост объёма сельскохозяйственных данных, который, по прогнозам, превысит 5,1 эксабайта к 2025 году, ставит точное животноводство на пересечение IoT-сенсорики, периферийных вычислений и аналитики машинного обучения (Scoop Market Research, 2025; Precision Business Insights, 2024). В рамках этой развивающейся цифровой экосистемы потоки биоакустических данных выделяются как особенно сложная и информационно насыщенная модальность. Эти непрерывные высокочастотные временные сигналы требуют специализированных конвейеров предобработки, надёжной инженерии признаков и масштабируемых аналитических платформ для извлечения практически применимых выводов. Опираясь на этот контекст, быстрый рост цифрового сельского хозяйства дополнительно подчеркнул преобразующий потенциал больших данных и машинного обучения в переформатировании животноводства в более устойчивый, ориентированный на благополучие и эффективный сектор. Среди различных сенсорных модальностей биоакустика стала мощным, но недостаточно используемым каналом информации, предоставляя неинвазивные сведения о здоровье, поведении и эмоциональном состоянии животных. В частности, вокализации крупного рогатого скота несут богатые индикаторы социального взаимодействия, эструса, материнской заботы, голода, стресса и боли, что делает их перспективными биомаркерами для мониторинга благополучия и автоматизированных систем управления фермой. Однако использование этих сигналов требует кураторских наборов данных, которые достоверно отражают акустические, поведенческие и экологические реалии коммерческого животноводства.
Нехватка крупных аннотированных наборов данных остаётся одним из наиболее значительных узких мест в исследованиях биоакустики крупного рогатого скота (Kate and Neethirajan, 2025). Традиционные методы акустического анализа, включающие ручную генерацию спектрограмм и извлечение признаков, информативны, но не масштабируемы до объёмов данных, необходимых для надёжного обучения ИИ, что подчёркивает критическую потребность в комплексных наборах данных, соответствующих принципам FAIR (Findable, Accessible, Interoperable, Reusable — находимые, доступные, совместимые, повторно используемые), которые отражают экологическую валидность и поддерживают аналитику больших данных. Важно, что принципы FAIR не требуют полной открытости всех данных; скорее, они подчёркивают прозрачные, машиночитаемые условия доступа, которые могут учитывать обоснованные ограничения, такие как конфиденциальность фермы (Martorana et al., 2022; Karakoltzidis et al., 2024).
Несмотря на растущий интерес, существующие корпусы вокализаций крупного рогатого скота остаются ограниченными по масштабу, охвату и воспроизводимости. Большинство предыдущих наборов данных собиралось на небольших когортах в контролируемых или однородных условиях, сосредотачиваясь преимущественно на узком наборе типов сигналов, таких как сигналы эструса или вокализации дистресса. Например, набор данных «BovineTalk» сообщал о более чем тысяче вокализаций, но только от 20 коров в изоляции, тем самым исключая экологический шум и поведенческое разнообразие. Аналогично, физиологические исследования, связывающие сигналы с кортизолом или эструсом, опирались на ограниченные условия, что ограничивает обобщаемость на коммерческие коровники. Эти ограничения препятствуют разработке моделей машинного обучения, способных обобщаться в различных фермерских средах, редких поведениях и переменных акустических условиях. Кроме того, мультимодальная интеграция аудио с видео или этологическими аннотациями реализуется редко, что ограничивает возможности контекстуализации вокализаций соответствующим поведением.
В дополнение к ограниченному поведенческому охвату, многие существующие наборы данных намеренно исключают фоновый шум для обеспечения чистых акустических сигналов. Хотя это упрощает анализ, это снижает экологическую валидность, поскольку коммерческие молочные коровники являются акустически сложными средами, содержащими механический шум, перекрывающиеся сигналы и человеческую активность. Модели, обученные на чистых лабораторных записях, часто терпят неудачу при развёртывании на реальных фермах, где вокальные сигналы встроены в гетерогенные звуковые ландшафты. Поэтому существует острая необходимость в наборах данных, отражающих акустическую реальность фермерских сред, балансируя чёткость сигнала с экологической подлинностью.
Чтобы устранить эти пробелы, мы представляем новый набор данных вокализаций крупного рогатого скота, который сочетает масштаб, поведенческое разнообразие и экологический реализм со строгими стандартами аннотирования и метаданных. Корпус включает 569 кураторских клипов, охватывающих 48 поведенческих классов, записанных на трёх коммерческих молочных фермах в Атлантической Канаде с использованием многомикрофонного мультимодального дизайна. Записывая аудио одновременно из нескольких зон коровника — кормовых проходов, поилок, доильных залов и мест отдыха — и связывая эти записи с видео-наблюдениями и подробными этологическими заметками, набор данных обеспечивает комплексное представление акустической и поведенческой экологии молочного скота. В отличие от более ранних коллекций, отдававших приоритет контролируемым условиям, этот ресурс охватывает сложность среды коровника, включая фоновые механизмы, перекрывающиеся сигналы и рутинную человеческую активность, тем самым повышая его ценность для разработки надёжных, готовых к полевым условиям аналитических моделей.
Ключевой вклад этого набора данных заключается в его этологически ориентированной схеме аннотирования, которая организует вокализации в девять основных категорий и 48 подтипов, охватывающих материнские, социальные, репродуктивные, кормовые, питьевые, связанные с обращением, дистрессовые, экологические и невокальные события. Каждый клип аннотирован поведенческим контекстом, эмоциональной валентностью и оценками уверенности, что позволяет проводить анализы, выходящие за пределы акустики, к вопросам благополучия, мотивации и социального взаимодействия. Эта структура согласуется с современными рамками благополучия животных, которые подчёркивают эмоциональную валентность и возбуждение, а также предоставляет машиночитаемые дескрипторы, подходящие для вычислительного моделирования. Не менее важно соответствие набора данных принципам FAIR. Таблицы метаданных документируют контекст записи, оборудование, характеристики клипов и параметры предобработки прозрачным и воспроизводимым образом. Включение акустических признаков, извлечённых с помощью стандартизированных конвейеров (Praat, librosa, openSMILE), обеспечивает совместимость с другими биоакустическими ресурсами животноводства и облегчает нижестоящие применения, от контролируемой классификации до исследовательского поведенческого анализа.
В совокупности эти элементы делают данный корпус наиболее комплексным и экологически валидным набором данных вокализаций крупного рогатого скота на сегодняшний день. Он предоставляет не только основу для продвижения подходов машинного обучения к анализу звуков животных, но и эталонный ресурс для исследователей в области поведения животных, науки о благополучии и точного управления животноводством. Для поддержки воспроизводимого повторного использования кураторские клипы и связанные метаданные размещены с ограниченным доступом в репозитории Zenodo с постоянным DOI, а полный конвейер предобработки и извлечения признаков выпущен как открытый исходный код на GitHub.
В дополнение к методологическим и научным вкладам, этот набор данных имеет непосредственное значение для развивающейся области точного животноводства. Обеспечивая обнаружение и интерпретацию вокальных сигналов, связанных со здоровьем, репродукцией и благополучием, он открывает пути для неинвазивных систем мониторинга, которые могут помогать фермерам в реальном времени. Раннее обнаружение эструса, дистресса или дискомфорта посредством автоматизированного вокального анализа может улучшить репродуктивное управление, снизить риски заболеваний и повысить общее благополучие стада. Помимо крупного рогатого скота, набор данных также вносит вклад в более широкое движение в области ориентированного на животных ИИ, где биоакустические данные всё чаще используются для предоставления «цифровых голосов» нечеловеческим видам. Недавняя работа по мониторингу поведения с помощью ИИ у овец и коз, например, продемонстрировала, как вокальные и поведенческие признаки могут быть сопоставлены с состояниями, связанными с благополучием, с использованием машинного обучения (Emsen et al., 2025). Наш набор данных вокализаций крупного рогатого скота расширяет эту линию работы на молочный скот, предоставляя дополнительный ресурс в растущей экосистеме инструментов ИИ, которые интегрируют анализ вокализаций с компьютерным зрением и данными носимых датчиков у жвачных видов.
Остальная часть статьи структурирована следующим образом. Раздел 2 представляет новизну набора данных, соотнося его с предыдущими исследованиями. Раздел 3 описывает протоколы сбора данных, включая места записи, оборудование и методы мультимодальной фиксации. Раздел 4 описывает конвейер предобработки, охватывающий профилирование шума, фильтрацию, шумоподавление, сегментацию и аннотирование. Раздел 5 детализирует создание набора данных, включая извлечение признаков, биологическую интерпретацию, дизайн метаданных и предварительные анализы. Наконец, Раздел 6 представляет обсуждение значимости и ограничений, а Раздел 7 завершает статью, подчёркивая её потенциал как эталона как для науки о благополучии животных, так и для приложений больших данных в сельском хозяйстве. Опираясь на эти мотивации, следующий раздел описывает новизну нашего набора данных по отношению к существующим корпусам вокализаций крупного рогатого скота.
2 Новизна набора данных
2.1 Масштаб и разнообразие записей
Эта работа представляет один из наиболее комплексных наборов данных вокализаций крупного рогатого скота на сегодняшний день. Корпус включает 569 клипов, охватывающих 48 поведенческих меток (классов), со средней длительностью клипа ~21 с (медиана ~13,8 с; диапазон 2,8–445 с). Анализ показывает распределение с длинным хвостом: крупнейшие классы, Estrus_Call (117 клипов) и Feed_Anticipation_Call (113 клипов), составляют 40% данных, тогда как многие категории содержат менее десяти образцов, отражая редкую и спонтанную природу некоторых поведений. Длительности клипов достаточно коротки, чтобы облегчить мелкозернистый акустический анализ, но достаточно длинны, чтобы охватить полную вокализацию плюс контекст. Подробная разбивка состава набора данных представлена в Дополнительной таблице S1, которая сообщает количество клипов и общую длительность по основной категории, подкатегории, ферме, зоне коровника и микрофону. Лежащие в основе метаданные и таблицы акустических признаков распространяются вместе с записью Zenodo, описанной в Заявлении о доступности данных, что позволяет другим исследователям подмножествовать корпус по поведенческому классу, контексту записи или конфигурации оборудования для целевых анализов.
Большинство опубликованных наборов данных сигналов крупного рогатого скота меньше как по масштабу, так и по охвату. Например, исследование «BovineTalk» изолировало 20 многорожавших коров на 240 мин после доения и получило 1144 вокализации (952 высокочастотных и 192 низкочастотных) (Gavojdian et al., 2024); авторы отметили, что сигналы записывались в идентичных условиях и исключали шум. Другое исследование проанализировало 12 тёлок голштинской породы и сообщило, что частота вокализаций достигала пика за один интервал до кульминации эструса и была выше при естественном, чем при индуцированном эструсе (Röttgen et al., 2018). (Yoshihara and Oya 2021) записали 290 сигналов от 32 коров в четырёх физиологических состояниях (предвкушение кормления, эструс, коммуникация и отёл) и показали, что интенсивность сигнала, высота тона и значения формант отражали изменения слюнного кортизола. (Katz 2020) зафиксировал 333 высокочастотных сигнала от 13 тёлок и продемонстрировал, что коровы сохраняют индивидуальные вокальные сигналы в разных контекстах. По сравнению с этими исследованиями, наш набор данных содержит как высокочастотные, так и низкочастотные сигналы в положительных и отрицательных контекстах, включает более богатый набор поведенческих классов (материнские, социальные, эструс, кормление, питьё, обращение, дистресс, экологические и невокальные), и охватывает несколько ферм и зон коровника. Эта широта позволяет проводить анализы поведенческого разнообразия и кросс-контекстной вариации, ранее невозможные.
Помимо масштаба и разнообразия, новизна также возникает из дизайна записи, который подробно описан в следующем подразделе.
2.2 Многомикрофонная установка и мультимодальная синхронизация
Записи собирались на трёх коммерческих молочных фермах голштинско-фризской породы в округе Сассекс, Нью-Брансуик, Канада, в течение трёх последовательных дней (5–7 мая 2025 г.), при этом одна ферма записывалась в день с 9:00 до 18:00 (Таблица 1). В этих местах было получено 65 исходных аудиофайлов, представляющих в общей сложности ~90 ч записей (65,57 ГБ; средняя длительность файла ~1 ч 24 мин, средний размер файла ~1,0 ГБ).
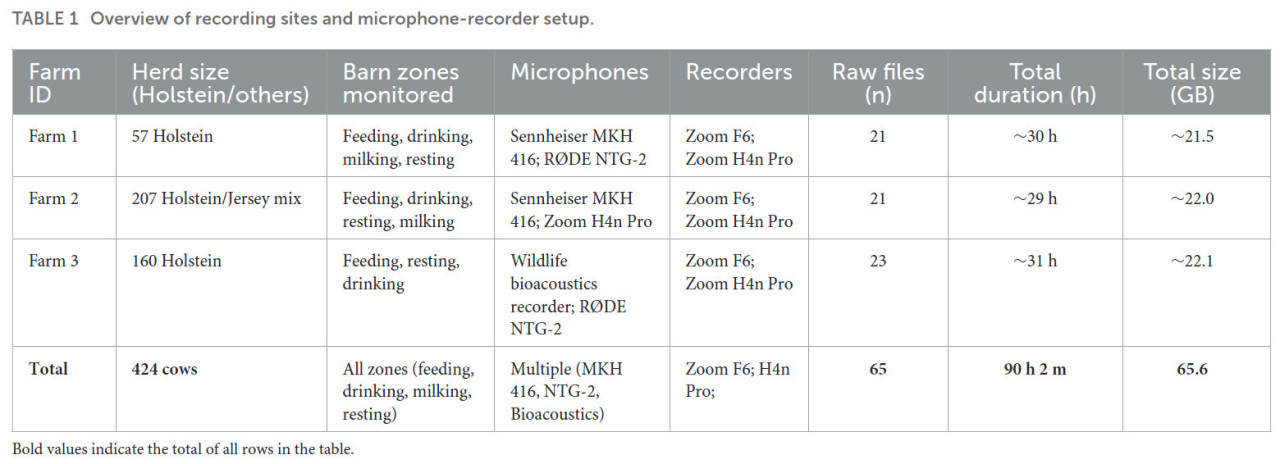
Таблица 1 Обзор мест записи и конфигурации микрофон-рекордер.
Жирные значения указывают на итог всех строк таблицы.
Набор данных охватывает четыре основных поведенческих контекста — питьё, кормление, доение и отдых — в средах коммерческих коровников. Эти условия включали естественные фоновые звуки, такие как лязг металлических ворот, вентиляторы, работающие тракторы, перекрывающиеся вокализации и другие рутинные шумы. Репрезентативный пример развёртывания в зоне кормления показан на Рисунке 1, где ружейный микрофон расположен совместно с потолочной экшн-камерой для достижения синхронизированной аудио-видео фиксации поведения коров у кормушки. Интегрируя несколько ферм и зон коровника, корпус отражает истинное акустическое разнообразие коммерческих молочных сред, а не контролируемые или лабораторные условия.
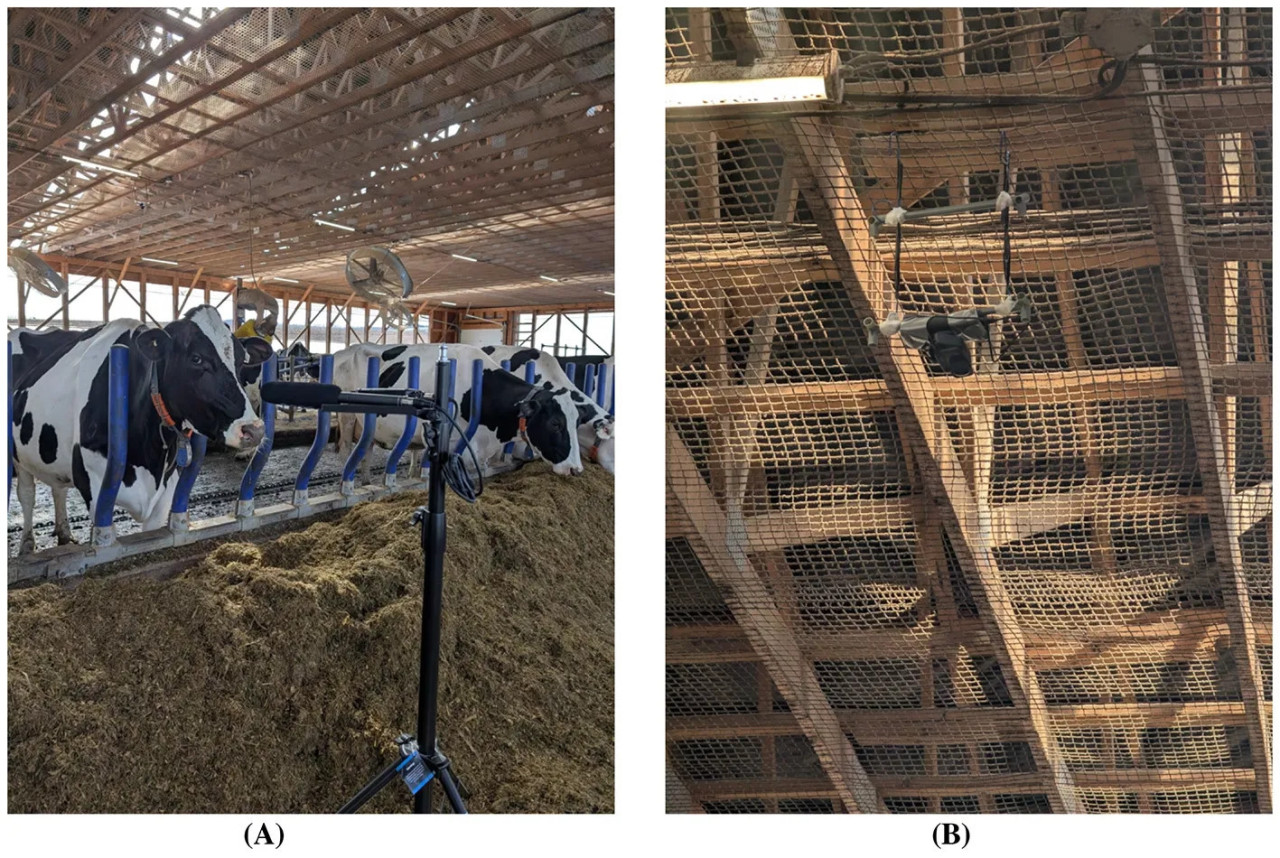
Рисунок 1 Многомикрофонная и видео-установка, используемая для синхронизированной мультимодальной записи в молочных коровниках. (A) Направленный ружейный микрофон RØDE NTG-2, подключённый к портативному рекордеру Zoom H4n Pro, развёрнутый в кормовой секции фермы. Установка была смонтирована на устойчивом штативе, ориентированном на кормушку, для фиксации высококачественных вокализаций при отклонении внеосевого шума коровника. (B) Потолочная экшн-камера GoPro, расположенная непосредственно над той же зоной на той же ферме, для фиксации непрерывного 4K-видео кормового поведения. Пространственное выравнивание микрофона и камеры обеспечивало точную перекрёстную ссылку между аудио и поведенческим контекстом во время ручного аннотирования и этологической валидации. (A) Установка микрофона в зоне кормления. (B) Установка камеры в зоне кормления.
Новизна этого корпуса заключается в его многомикрофонном, мультисенсорном дизайне. В отличие от более ранних исследований вокализаций крупного рогатого скота, которые полагались на один микрофон или контролируемые условия, настоящий набор данных интегрирует записи с нескольких ферм, зон коровника и типов оборудования. Направленные ружейные микрофоны (Sennheiser MKH 416, RØDE NTG-2) обеспечивали близкодействующие вокализации с высоким отношением сигнал/шум, тогда как портативные рекордеры (Zoom H4n Pro, Zoom F6) и автономный регистратор Wildlife Bioacoustics фиксировали более длительные фоновые звуковые ландшафты.
Этот дизайн обеспечивал представление как фокальных вокальных событий (например, сигналов эструса, предвкушения кормления), так и фонового акустического контекста (например, перекрывающихся мычаний, механизмов коровника, человеческой активности). Включение видеозаписей с нескольких камер GoPro добавило дополнительное визуальное измерение, позволяя перекрёстно ссылаться на акустические события с поведенческим контекстом. В совокупности эта мультимодальная, мультисенсорная стратегия создаёт целостный, воспроизводимый набор данных, который фиксирует акустическую реальность коммерческих молочных сред в беспрецедентном масштабе и разрешении. Этот дизайн также поддерживает нижестоящие статистические анализы, которые явно учитывают ферму, зону коровника и микрофон как потенциальные источники дисперсии (Раздел 5.6), позволяя пользователям количественно оценить, какая часть акустической изменчивости возникает из-за экологических и аппаратных факторов по сравнению с поведенческим классом.
2.3 Профилирование экологического шума
Молочные коровники акустически сложны, с постоянным шумом механизмов (доильные роботы, кормораздатчики, тракторы), лязгом металлических ворот, ударами копыт, разговорами людей, мочеиспусканием и ветром. Для обеспечения надёжного извлечения вокализаций отдельные записи шума из каждой зоны анализировались с использованием метода Уэлча с окном БПФ на 16 384 отсчёта. Полученный инвентарь шума (Таблица 4) суммирует спектральный диапазон и амплитуду различных источников шума. Шум питья exhibited низкие частоты около 20 Гц и широкие высокочастотные пики до 1029 Гц; средняя пиковая амплитуда по образцам составила ~−40 дБ. Шум кормления (смесь шипения, рогов и ударов ворот) имел низкие частоты от 30 Гц и высокочастотные компоненты до ~567 Гц с аналогичной амплитудой. Шум доения от роботизированного оборудования был доминирован низкими частотами около 12 Гц и высокими частотами до ~300 Гц и был громче (средняя амплитуда ~−22 дБ). Шум отдыха (мочеиспускание и человеческая речь) охватывал 12–493 Гц со средней амплитудой ~−21 дБ. Эти профили информировали дизайн полосового фильтра (150–800 Гц) для удаления низкочастотного шума механизмов и высокочастотного электрического шипения при сохранении полосы вокализаций. Предоставляя количественный инвентарь шума, наш набор данных позволяет исследователям воспроизвести конвейер предобработки и оценить устойчивость акустических признаков к фоновому шуму.
2.4 Схема аннотирования и этологическая основа
Ключевая новизна набора данных — его подробная схема аннотирования (Таблица 2), основанная на этологических принципах и протоколах благополучия. Система аннотирования организует вокализации в девять основных категорий:
- Материнская коммуникация и коммуникация телят — включает такие сигналы, как Mother_Separation_Call (низкочастотный жалобный сигнал, когда корова отделена от телёнка), Calf_Contact_Call (высокочастотный визг, когда телёнок ищет контакта), и Maternal_Response_Call (корова-мать отвечает своим телятам).
- Социальное распознавание и взаимодействие — охватывает аффилиативные сигналы, такие как Greeting_Moo, Group_Contact_Call, Response_Exchange_Call, Herd_Coordination_Call и Social_Bonding, отражающие социальную иерархию и сплочённость.
- Эструс и брачное поведение — включает Estrus_Call, характеризующийся громким высокочастотным рёвом, сигнализирующим о половой рецептивности; Mating_Excitement_Call; и Mounting_Associated_Call.
- Кормление и голод — охватывает Feed_Anticipation_Call (сигналы перед кормлением), Feeding_Fustration_Call и Chewing_Rumination_Sounds (невокальные жевательные звуки).
- Вода и жажда — включает Drinking_Slurping_Sounds, Water_Anticipation_Call и Hydration_Distress.
- Дистресс и боль — охватывает High_Frequency_Distress (интенсивные вокализации дистресса), Frustration_Call, Injury_Pain_Moo, Sneeze, Cough и Burp.
- Экологические и ситуационные — включает вокальные реакции на экологические стимулы, такие как Weather_Response_Call, Transportation_Stress_Call и Confinement_Protest_Call.
- Невокальные звуки — включает невокальные поведения, такие как Breathing_Respiratory_Sounds и Licking_Sounds.
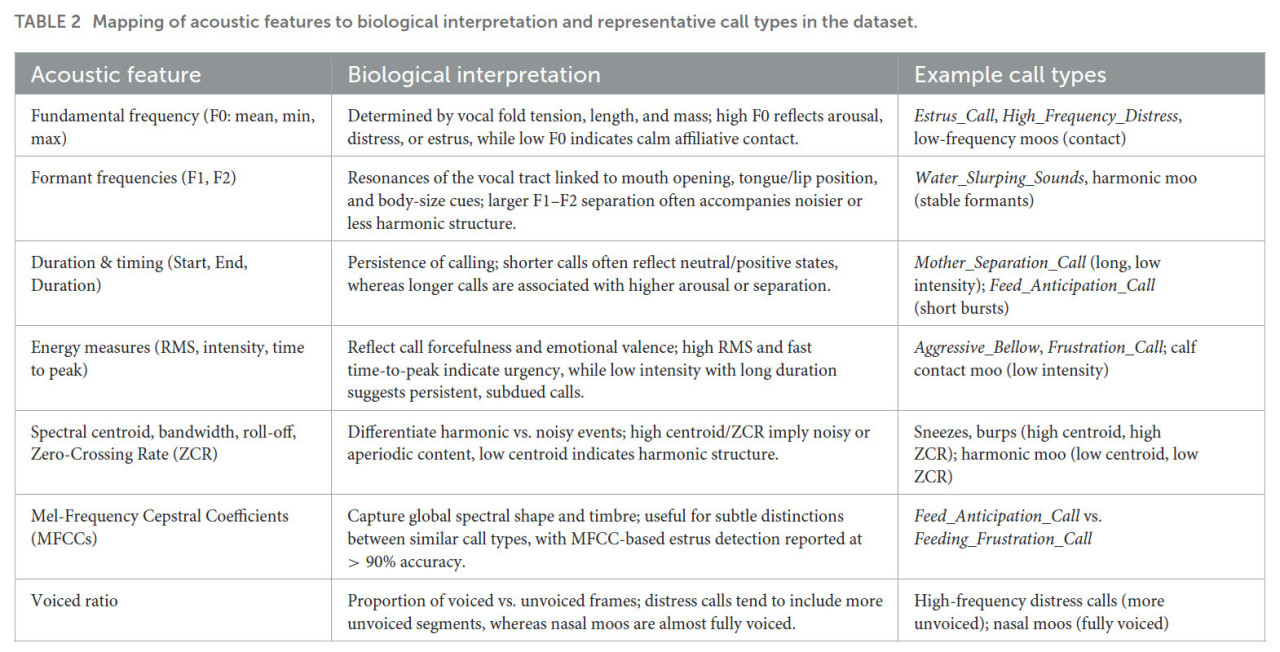
Таблица 2 Сопоставление акустических признаков с биологической интерпретацией и репрезентативными типами сигналов в наборе данных.
Каждая подкатегория сопровождается кратким описанием (например, Estrus_Call — это продолжительный высокочастотный сигнал, издаваемый рецептивной самкой; Feed_Anticipation_Call — это ритмичное мычание, производимое, когда коровы ожидают кормления). Категории намеренно охватывают положительные и отрицательные состояния благополучия в соответствии с наукой о благополучии. Предыдущие исследования поддерживают эту этологическую структуризацию: высокочастотные сигналы с открытым ртом связаны с дистрессом или коммуникацией на большие расстояния, тогда как низкочастотные сигналы с закрытым ртом возникают в спокойных социальных контекстах (Jobarteh et al., 2024). Частота вокализаций также даёт поведенческие подсказки — например, (Röttgen et al. 2018) обнаружили, что частота сигналов достигает пика перед кульминацией эструса, а (Yoshihara and Oya 2021) связали повышенные частоты формант с повышенным кортизолом во время отёла. Фиксируя широкий спектр вокальных типов и невокальных звуков, наша схема аннотирования позволяет анализировать как эмоциональную валентность, так и возбуждение, как рекомендуется в современных рамках благополучия животных.
2.5 Богатые метаданные и соответствие FAIR
Набор данных сопровождается комплексной таблицей метаданных (Таблица 7), описывающей каждый клип. Ключевые поля включают уникальное имя файла, дату записи, идентификатор фермы, зону коровника, модель микрофона, длительность, статистику высоты тона (среднее, минимальное и максимальное), и частоты формант (F1 и F2), а также категориальные аннотации, такие как основная категория, подкатегория, эмоциональный контекст, оценка уверенности и текстовое описание. Определения признаков следуют акустическим и этологическим соглашениям — например, высота тона связана с натяжением гортани и возбуждением, расстояние между формантами отражает длину голосового тракта, а энергетические меры указывают на силу сигнала.
Структура метаданных соответствует руководящим принципам FAANG (Functional Annotation of Animal Genomes — функциональная аннотация геномов животных) для метаданных животных и придерживается принципов FAIR (Harrison et al., 2018). Эти принципы гарантируют, что наборы данных описываются с помощью богатых метаданных, используют общественные стандарты и хранятся в форматах, облегчающих долгосрочное повторное использование в исследовательских сообществах. Применение FAIR к биоакустическим корпусам повышает прозрачность, воспроизводимость и интеграцию с другими наборами данных по геномике животных и благополучию (Harrison et al., 2018).
В целом, новизна набора данных заключается в его масштабе, разнообразии, многомикрофонном дизайне, мультимодальном референсировании, подробной этологически ориентированной схеме аннотирования и структуре метаданных, соответствующей международным стандартам. По сравнению с предыдущими исследованиями вокализаций крупного рогатого скота, которые фокусировались на небольших когортах или узких поведенческих контекстах, этот корпус предлагает более целостный и воспроизводимый ресурс для продвижения машинного обучения и исследований благополучия молочного скота. Установив охват и сравнительную новизну набора данных, мы теперь описываем процесс сбора данных, включая места записи, оборудование и фиксацию поведенческого контекста.
3 Сбор данных
3.1 Места записи
Данные собирались на трёх коммерческих молочных фермах в округе Сассекс, Нью-Брансуик, закодированных FARM1–FARM3, все из которых эксплуатировали коровники со свободным содержанием (Таблица 1). Ферма 1 содержала 57 коров голштинской породы, Ферма 2 содержала 207 коров в смешанном стаде голштинской и джерсейской пород, а Ферма 3 содержала 160 коров голштинской породы. Запись проводилась во время последовательных выездов на места (5–7 мая 2025 г.), обеспечивая охват ферм в сопоставимых сезонных условиях.
Каждый коровник был разделён на четыре контролируемые зоны — поилки, кормовые проходы, доильный зал и места отдыха. В каждой зоне микрофоны устанавливались в фиксированных местах крепления (например, над или рядом с поилками, возле кормушек или вдоль фронтов мест отдыха), выбранных так, чтобы совпадать с областями, где коровы неоднократно собираются. Вместо принудительного единого фиксированного расстояния источник-микрофон, этот дизайн отражал то, как животные естественно перемещаются через эти пространства. Когда коровы приближались, кормились, пили, стояли в очереди на доение или ложились, их вокализации обычно производились в практическом диапазоне расстояний примерно 0,5–3 м от ближайшего микрофона, в зависимости от их мгновенного положения и ориентации. Эта зональная компоновка обеспечивала одновременную, зонально-специфичную запись и предоставляла систематические контрасты между различными акустическими средами, такими как кормовые зоны, доильные станции и места отдыха.
Кроме того, на протяжении всего времени велись журналы ручного наблюдения, фиксирующие такие события, как графики кормления, визиты ветеринара или техническое обслуживание механизмов. Эти журналы гарантировали, что контекстные события были связаны с акустическими данными, создавая разнообразный звуковой ландшафт, репрезентативный для повседневных практик животноводства в молочных коровниках Атлантической Канады.
Для эффективной фиксации этих сред была развёрнута многомикрофонная аппаратная установка, как описано ниже.
3.2 Аппаратное обеспечение для записи и размещение микрофонов
Для обеспечения репрезентативного акустического охвата был развёрнут многомикрофонный массив, сочетающий направленные ружейные микрофоны с портативными рекордерами и одним автономным биоакустическим регистратором:
- Sennheiser MKH 416 — гиперкардиоидный ружейный микрофон с интерференционной трубкой, широко используемый в кино- и wildlife-записи. Его сильное подавление боковых сигналов позволяло фиксировать тонкие вокальные нюансы несмотря на шум коровника (Sennheiser, 2023).
- В паре с Zoom F6 — шестиканальным портативным рекордером с фантомным питанием. F6 поддерживал 32-битную плавающую запись, двойные АЦП и сверхнизкошумовые предусилители, предотвращая клиппинг даже при высокоинтенсивных сигналах (Zoom, 2023).
- RØDE NTG-2 — суперкардиоидный ружейный микрофон с батарейным/фантомным питанием, ценимый за доступность и портативность, подходящий для близкодействующих записей в контекстах питья и доения (RØDE, 2023).
- В паре с Zoom H4n Pro — четырёхдорожечным портативным рекордером, питаемым двумя внутренними аккумуляторами AA. H4n Pro включал встроенные стереомикрофоны X/Y, двойные входы XLR и 24-битную запись с максимальной обработкой SPL 140 дБ (Zoom, 2022). Две такие пары RØDE NTG-2 + H4n Pro были развёрнуты для зонально-специфичного охвата.
- Автономный регистратор Wildlife Bioacoustics — единственный пассивный регистратор, запрограммированный на плановый мониторинг, особенно в зонах отдыха. Он работал непрерывно на четырёх аккумуляторах AAA, обеспечивая длительную фиксацию без присутствия человека (Wildlife Acoustics, 2023).
Характеристики файлов: записи Zoom F6 были в среднем самыми крупными (~1,7 ГБ, средняя пиковая амплитуда −43,7 дБ, диапазон 20–1029 Гц), за ними следовали Zoom H4n Pro (~1,6 ГБ, −30,5 дБ, 20–820 Гц). Автономный регистратор производил меньшие файлы (~308 МБ, −20,1 дБ, 12–893 Гц). По контексту зона питья генерировала наибольший объём исходных данных (~3,65 ГБ), за ней следовали кормление (~1,7 ГБ), доение (~762 МБ) и отдых (~450 МБ).
Камеры: пять фиксированных экшн-камер GoPro были установлены над зонами коровника, записывая непрерывно в 4K/30 кадров/с с широкоугольными объективами для покрытия кормовых проходов, мест отдыха, поилок и доильного зала. Камеры синхронизировались с аудио через общий таймкод.
Стратегия размещения: микрофоны монтировались на регулируемых стойках ~1 м выше высоты головы коровы, ориентированных на центр зоны. Это предотвращало контакт с животными, минимизировало отражения от стен и обеспечивало зонально-специфичную фиксацию. Кабели прокладывались вдоль балок и стоек штативов и экранировались для предотвращения пережёвывания. Многомикрофонный массив (Рисунок 2) обеспечивал одновременную многозональную запись и кросс-сравнение сигналов в различных средах.
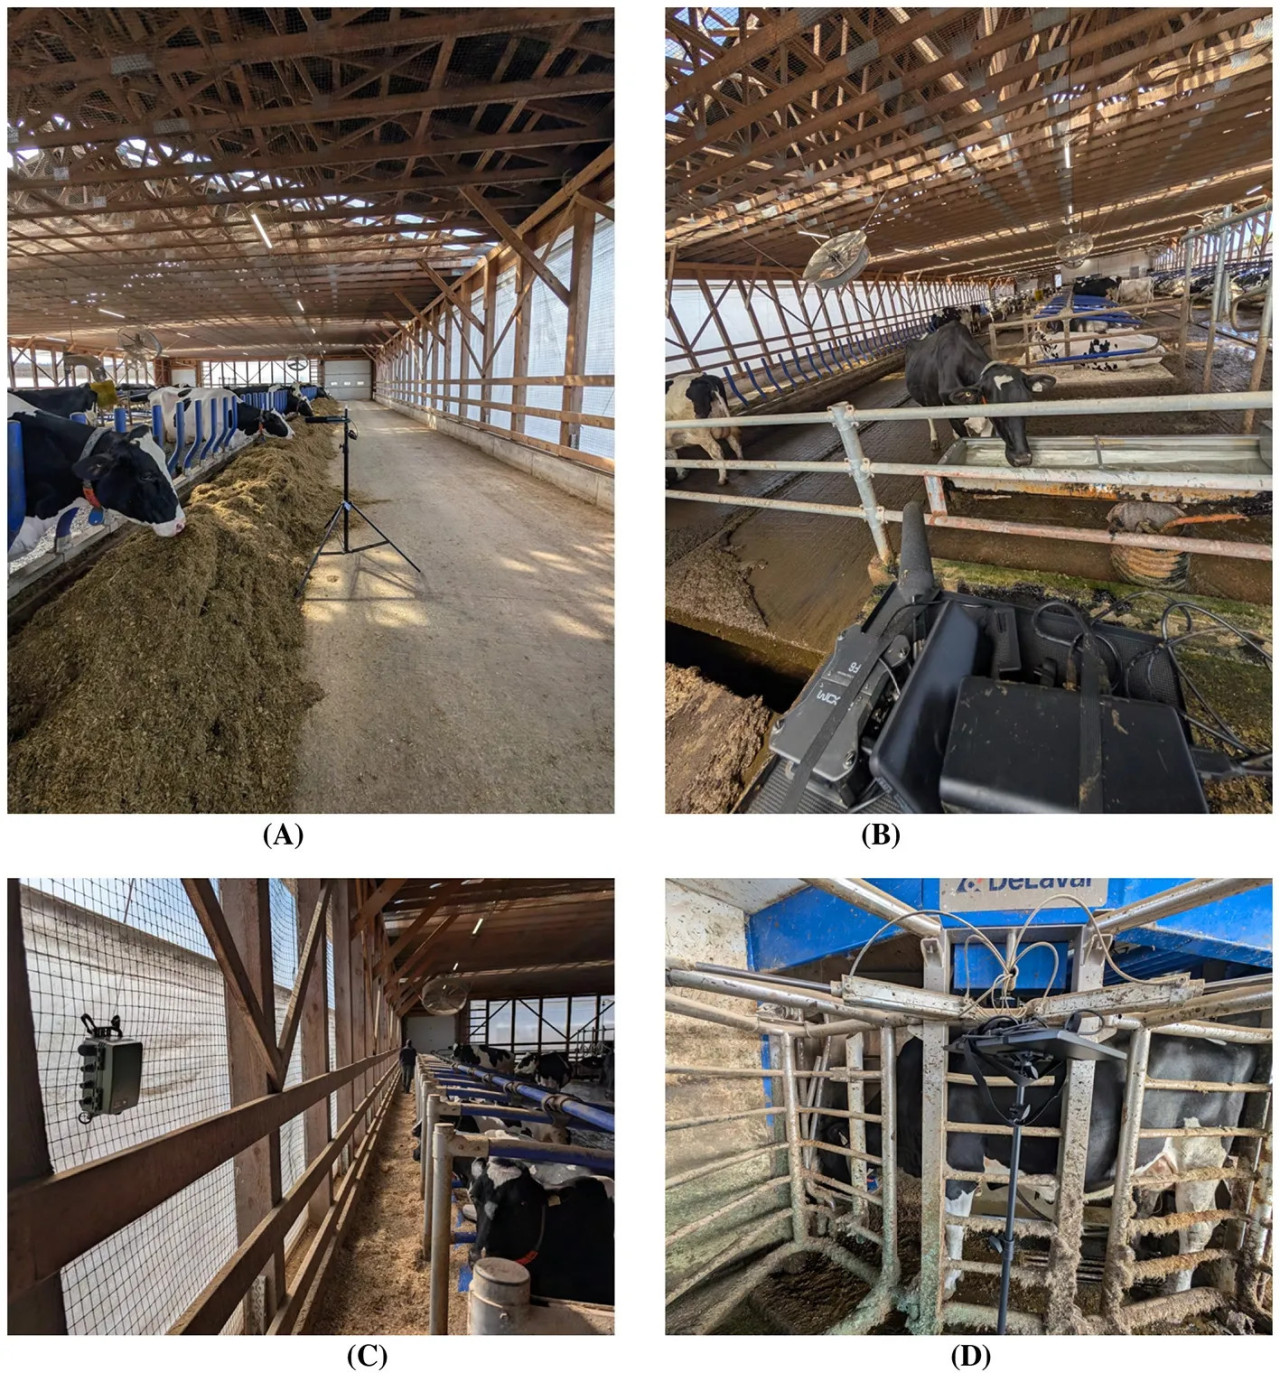
Рисунок 2 Установки микрофонов в зонах коровника на Ферме 1. (A) Ружейный микрофон RØDE NTG-2, расположенный вдоль кормового прохода для фиксации близкодействующих вокализаций во время кормовой активности при минимизации боковых отражений. (B) Направленный микрофон Sennheiser MKH 416, размещённый возле поилки для записи высокочистых вокальных и невокальных событий среди тракторов и металлического шума. (C) Автономный регистратор Wildlife Bioacoustics, установленный в зоне отдыха для фиксации низкочастотных мычаний и фоновых групповых вокализаций без присутствия человека. (D) RØDE NTG-2 с портативным рекордером Zoom H4n Pro, расположенный возле доильной станции для документирования вокальных и невокальных звуков, связанных с обращением и доильными процедурами.
Эта комбинация оборудования обеспечивала комплементарные перспективы: установки Sennheiser + Zoom F6 с фантомным питанием для высококачественной фокальной записи, пары RØDE + Zoom H4n Pro с питанием от AA для гибкого мобильного охвата, и регистратор Wildlife Acoustics с питанием от AAA для автономного долгосрочного мониторинга. Вместе с параллельной видеозаписью установка сохраняла как индивидуальные вокальные признаки, так и групповой акустический контекст, формируя надёжную основу для поведенческих и машинно-обучаемых анализов.
Полные спецификации микрофонов и рекордеров, включая зоны развёртывания, длительности записи, размеры файлов и частотные диапазоны для каждой конфигурации, суммированы в Таблице 3. Поскольку коровы свободно перемещались в этих контролируемых зонах, эффективное расстояние источник-микрофон естественно варьировалось от сигнала к сигналу. На практике вокализации обычно производились, когда коровы находились у фокальных мест (кормовой рельс, поилка, вход в доильный зал, фронт стойла) или проходили через них, что приводило к типичному диапазону расстояний около 0,5–3 м от микрофона. Эта вариабельность была намеренной: цель состояла в воспроизведении акустических условий, в которых работали бы реальные системы мониторинга фермы, а не в принудительной лабораторной фиксированной геометрии.
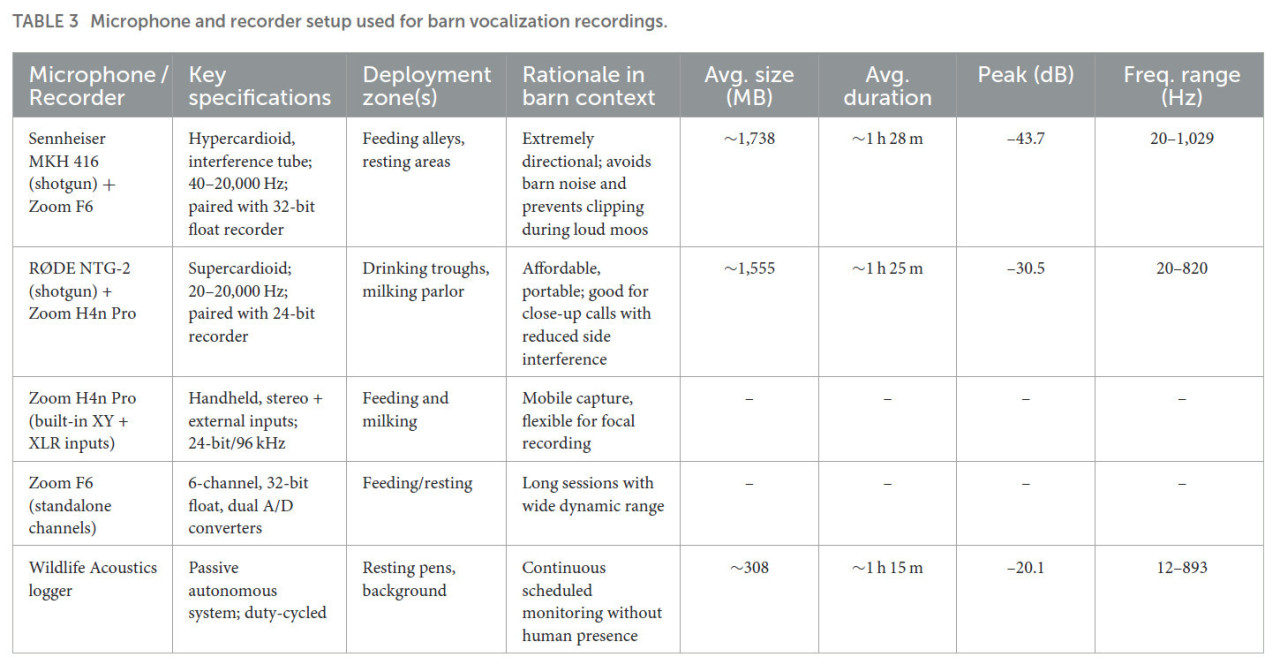
Таблица 3 Конфигурация микрофонов и рекордеров, используемая для записей вокализаций в коровнике.
Направленные характеристики MKH 416 и NTG-2 частично компенсируют затухание, связанное с расстоянием, путём преимущественной фиксации звуков в их фронтальных диаграммах направленности и подавления большей части внеосевого шума механизмов и коровника. На этапе анализа наш конвейер извлечения признаков включает нормализацию амплитуды и z-стандартизацию, что снижает влияние различий абсолютной интенсивности, возникающих из-за вариации расстояния. Более того, большинство из 24 акустических признаков, используемых в последующих моделях — таких как фундаментальная частота, отношения формант, спектральный центроид и MFCC — описывают форму и структуру сигнала, а не его абсолютную амплитуду, и поэтому относительно устойчивы к умеренным изменениям расстояния.
В совокупности зональное фиксированное размещение микрофонов и расстояние-устойчивый дизайн признаков гарантируют, что набор данных фиксирует реалистичную вариабельность условий записи, оставаясь подходящим для применений машинного обучения.
3.3 Фиксация поведенческого контекста
Одно аудио редко передаёт полное значение вокализаций. Для обеспечения поведенческого контекста проект реализовал протокол мультимодальной фиксации. Поведенческое видео записывалось с использованием фиксированных камер GoPro, описанных выше, и три исследователя вели ручные заметки, документирующие время суток, погодные условия, графики кормления, события доения и заметные социальные взаимодействия или стрессоры между коровами. Структура аннотирования была основана на четырёх вопросах Тинбергена (Bateson and Laland, 2013), которые остаются центральными в исследованиях поведения животных. В контексте вокализации коров они могут быть адаптированы следующим образом:
- Функция (адаптивная ценность): Какую роль сигнал играет в повседневной жизни? Например, облегчает ли он координацию кормления, сигнализирует о дистрессе или привлекает социальное внимание?
- Филогения (эволюционный фон): Как вокальные признаки у молочного скота соотносятся с таковыми у других быков или одомашненных видов?
- Механизм (причинность): Какие непосредственные физиологические или экологические факторы запускают вокализацию (например, голод, боль, разлука, обращение или шум коровника)?
- Онтогенез (развитие): Как вокальное поведение варьируется с возрастом, паритетом или опытом (например, тёлки против многорожавших коров)?
Связывая проксимальные механизмы (физиология, среда) с конечными функциями (коммуникация, адаптация), эта структура укрепляет интерпретацию набора данных за пределами одной акустики. Например, высокочастотные сигналы с открытым ртом могут быть связаны с непосредственным возбуждением или стрессом, одновременно выполняя долгосрочные коммуникативные роли в стаде (Jobarteh et al., 2024).
Выравнивание аудио-видео выполнялось вручную. Вместо использования автоматизированного оборудования синхронизации, исследователи перекрёстно ссылались на временные метки аудиозаписей с видеоматериалами и собственными журналами наблюдений. Этот практический подход позволял сопоставлять вокальные события с видимыми поведениями (такими как кормление, отдых или реакция на обращение) без специализированных инструментов.
3.4 Обработка и хранение файлов
Полевые данные первоначально хранились на внутренних картах памяти рекордеров Zoom и камер GoPro. Для предотвращения перезаписи или случайной потери данных записи с каждой фермы передавались сразу после дневного сбора данных. Файлы копировались на защищённый ноутбук на месте, а затем загружались в общий репозиторий Dropbox, обеспечивая как немедленное резервное копирование, так и удалённый доступ. Аудиозаписи сохранялись в формате WAV (44,1 или 48 кГц, 24-битная глубина) и именовались по структурированному соглашению: FarmID - MicrophonePlacement - BarnZone - Date - Time. Видеофайлы хранились в формате MP4 с соответствующими временными метками для поддержания перекрёстных ссылок с аудио.
Для защиты целостности данных исходные оригинальные файлы остаются заархивированными в Dropbox. Для последующих этапов анализа, таких как предобработка, очистка и сегментация, рабочие копии загружались и обрабатывались локально, гарантируя сохранение исходного набора данных без изменений. Таблицы метаданных обновлялись при каждой передаче для регистрации имён файлов, времён, использованного оборудования и статуса резервного копирования. Этот многоэтапный подход к обработке — карта памяти → ноутбук → облачное резервное копирование → рабочие копии — обеспечивал надёжный и прослеживаемый рабочий процесс, минимизирующий риск потери данных и поддерживающий строгое разделение между исходными и обработанными наборами данных.
3.5 Рабочий процесс обработки данных
Для эффективного управления и анализа ~90 ч мультимодальных записей (65 исходных файлов; 65,6 ГБ) был установлен модульный и воспроизводимый рабочий процесс обработки данных в соответствии с принципами FAIR и FAANG. Вместо полностью распределённой вычислительной системы этот рабочий процесс лучше всего понимать как набор чётко определённых этапов пакетной обработки, которые могут быть масштабированы до распределённых или облачных платформ в будущей работе. Рабочий процесс (Рисунок 3) интегрирует пять последовательных этапов, от приёма до аналитики, обеспечивая прослеживаемую и масштабируемую обработку биоакустических данных животноводства.
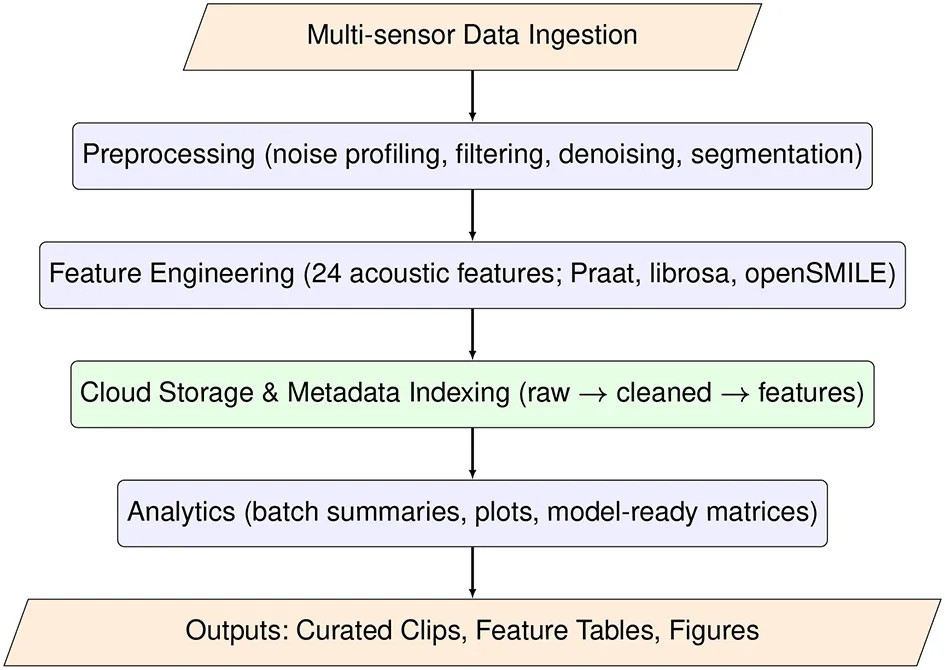
Рисунок 3 Модульный рабочий процесс обработки данных для набора данных биоакустики крупного рогатого скота, показывающий последовательные этапы приёма данных, предобработки (фильтрация и шумоподавление), ручной сегментации, инженерии акустических признаков, хранения и индексации метаданных, а также нижестоящей аналитики и машинного обучения.
Обработка выполнялась на рабочей станции, оснащённой процессором Intel Core i9-12900K (16 ядер, 24 потока), 64 ГБ ОЗУ и графическим процессором NVIDIA RTX 3090 (24 ГБ видеопамяти). Основное хранилище состояло из 4 ТБ NVMe SSD с непрерывным облачным резервным копированием в репозиторий Dropbox на 2 ТБ для резервирования и удалённого доступа. Все основные этапы были реализованы на Python 3.10 с использованием библиотек с открытым исходным кодом, гарантируя, что рабочий процесс может быть воспроизведён без доступа к проприетарному программному обеспечению. Рабочий процесс включает следующие компоненты:
- Приём данных — мультисенсорные аудио- и видеопотоки с трёх ферм были организованы с использованием структурированного соглашения об именовании файлов с временными метками, кодирующего ферму, зону коровника, дату, время и идентификатор устройства. Исходные файлы WAV (44,1/48 кГц, 24-бит) принимались через скрипты Python, которые использовали librosa для ввода/вывода аудио и pandas для регистрации метаданных уровня файла. Этот автоматизированный этап приёма стандартизировал форматы файлов, проверял наличие повреждённых или неполных записей и заполнял таблицы метаданных для нижестоящей обработки.
- Предобработка — исходные записи обрабатывались пакетами в соответствии со стандартизированными этапами, изложенными в разделах 4.1–4.4, включая спектральное профилирование шума, полосовую фильтрацию, адаптивное шумоподавление, ручную сегментацию и акустическую проверку. Пакетная предобработка была реализована на Python 3.10 для стандартизации качества сигнала в гетерогенных средах коровника. Мы применяли фильтр Баттерворта четвёртого порядка (50–1800 Гц) с использованием scipy.signal для изоляции частотного диапазона, релевантного вокализациям крупного рогатого скота, и ослабления низкочастотного шума механизмов и высокочастотных артефактов. Затем выполнялось шумоподавление на основе спектрального стробирования с библиотекой noisereduce для подавления нестационарного фонового шума при сохранении вокальной структуры. Параллельно ручная сегментация выполнялась в Raven Lite 2.0 с использованием спектрограммы и синхронизированного видео для идентификации отдельных вокальных событий и исключения чисто механических или невокальных звуков.
- Инженерия признаков — для каждого сегментированного клипа мы получали 24-мерный вектор акустических признаков, разработанный для фиксации ключевых временных, вокальных, спектральных и кепстральных свойств вокализаций крупного рогатого скота. Основные признаки, связанные с источником (фундаментальная частота, частоты формант, интенсивность и отношение гармоник к шуму), извлекались с использованием Parselmouth, интерфейса Python к Praat. Дополнительные спектральные дескрипторы, такие как спектральный центроид, полоса пропускания, срез, среднеквадратичная (RMS) энергия и частота переходов через ноль, а также мел-частотные кепстральные коэффициенты (MFCC), вычислялись с использованием librosa (версия 0.10.1). Для кросс-валидации и расширенных наборов признаков мы дополнительно использовали openSMILE (версия 2.3.0).
- Хранение и индексация метаданных — очищенные аудиоклипы, таблицы признаков и контекстные метаданные хранились в структурированной иерархии каталогов, которая чётко разделяла исходные и обработанные данные и поддерживала долгосрочное повторное использование. Оригинальные записи архивировались в папке /raw, шумоподавлённые и отфильтрованные клипы хранились в /processed, таблицы признаков по клипам сохранялись в /features, контекстная и схематическая информация в /metadata, а файлы аннотаций (например, метки, временные границы) в /annotations. Эта компоновка гарантировала, что каждый обработанный объект может быть прослежен до его исходного файла и связанных метаданных.
- Аналитика и генерация выходных данных — агрегированные таблицы признаков анализировались с использованием pandas и scipy.stats для выполнения описательной статистики и инференциальных тестов, включая тесты Крускала-Уоллиса и пост-хок сравнения Данна. Визуализации, такие как скрипичные диаграммы, панели спектрограмм и диаграммы Парето, генерировались с помощью matplotlib и seaborn для характеристики распределений по классам и структуры набора данных. Модели машинного обучения обучались и оценивались с использованием scikit-learn (версия 1.3.0) и PyTorch (версия 2.0), что позволяло применять как классические, так и глубокие подходы к одним и тем же стандартизированным наборам признаков.
3.5.1 Соображения масштабируемости
Хотя все анализы в этом исследовании проводились на одной рабочей станции, модульный дизайн рабочего процесса облегчает будущее масштабирование. Этапы приёма, предобработки и извлечения признаков могут быть распараллелены с использованием таких платформ, как Apache Spark или Dask; хранилище может быть перенесено в облачные объектные хранилища, такие как Amazon S3 или Google Cloud Storage, для многосайтовых развёртываний; и весь конвейер может быть контейнеризован с использованием Docker для поддержки воспроизводимого выполнения в различных вычислительных средах.
Поскольку исходные записи защищены на фермах и в зонах коровника, следующий Раздел 4 детализирует конвейер предобработки, применённый для повышения качества сигнала и подготовки клипов к сегментации и аннотированию.
3.6 Этические одобрения
Все экспериментальные процедуры были рассмотрены и одобрены Комитетом по этике животных Университета Далхаузи (Протокол № 2024–026). Сбор данных не включал физического взаимодействия с животными, и все участвующие владельцы ферм были полностью проинформированы о целях исследования и предоставили письменное согласие. В соответствии с институциональными и национальными этическими стандартами данные получали исключительно посредством пассивных аудио-, фото- и видеозаписей.
4 Предобработка данных
4.1 Профилирование шума
Спектральное профилирование шума проводилось в качестве первого этапа предобработки, поскольку исходные записи коровника содержали широкий спектр фоновых звуков от механизмов, металлических ворот, ударов копыт, людей и других животных. Этот процесс включал анализ паттернов фонового шума в терминах частоты (Гц) и амплитуды (дБ) для различения вокализаций коров от экологических источников. Сегменты только шума извлекались из записей для каждой зоны коровника и анализировались с использованием Audacity с функцией спектра Уэлча, настроенной с окном БПФ на 16 384 точки, 50% перекрытием и логарифмической осью частот. Метод Уэлча был выбран потому, что он усредняет перекрывающиеся сегменты, давая более гладкие спектры и подавляя переходные пики. Рассматривались альтернативные методы, такие как Бартлетта (меньшее сглаживание), Блэкмана-Харриса (подходит для контролируемого студийного аудио) и Ханнинга (нестабилен в шумных условиях коровника), но Уэлч оказался наиболее надёжным для реальных фермерских записей. Анализ выявил различные шумовые сигнатуры для разных зон коровника.
- Зоны питья были доминированы металлическим лязгом поилок, всплесками у корыт и шумом кишечника, с частотными пиками, простирающимися до примерно 1029 Гц, и средними амплитудами около −60 дБ.
- Зоны кормления производили смесь металлических ударов, шипения сжатого воздуха и рогообразных звуков, охватывающих 30–300 Гц с переменными амплитудами.
- Доильные залы характеризовались роботизированными системами, насосами и вакуумными линиями, которые генерировали относительно узкие частотные полосы вокруг 100–200 Гц, но с более высокими амплитудами между −10 и −36 дБ.
- Зоны отдыха содержали низкочастотные компоненты между 25–80 Гц от мочеиспускания, руминации и гула оборудования, в сочетании с высокочастотными звуками, такими как разговоры людей.
- Кроме того, шипение микрофона стабильно обнаруживалось ниже 50 Гц на всех фермах и зонах.
Эти результаты соответствовали ожиданию, что специфичные для коровника активности и оборудование вносят характерные сигнатуры фонового шума, которые перекрываются с вокальным частотным пространством коров.
Профили суммированы в Таблице 4, которая представляет распределение источников шума, частотных диапазонов, амплитуд и используемых микрофонов по фермам и зонам коровника. Эта информация непосредственно информировала дизайн конвейера фильтрации, применённого в последующей предобработке, где полосовая фильтрация была настроена для сохранения основного вокального диапазона (~100–1800 Гц) при ослаблении гула механизмов, человеческой речи и высокочастотного шипения. Репрезентативное сравнение спектрограмм и осциллограмм (Рисунок 4) противопоставляет вокализацию коровы сегменту только шума, иллюстрируя необходимость профилирования шума перед сегментацией и извлечением признаков. Эти зонально-специфичные спектральные профили шума затем непосредственно информировали выбор параметров для полосовой фильтрации и спектрального шумоподавления на последующих этапах предобработки (Разделы 4.2–4.4).
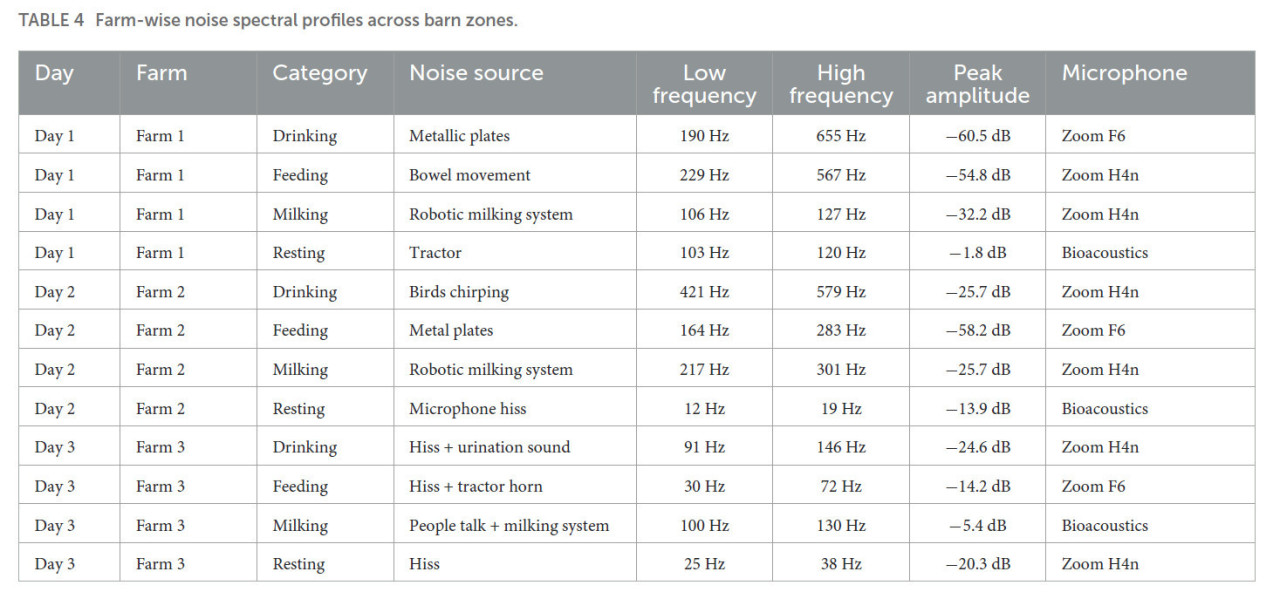
Таблица 4 Спектральные профили шума по фермам и зонам коровника.
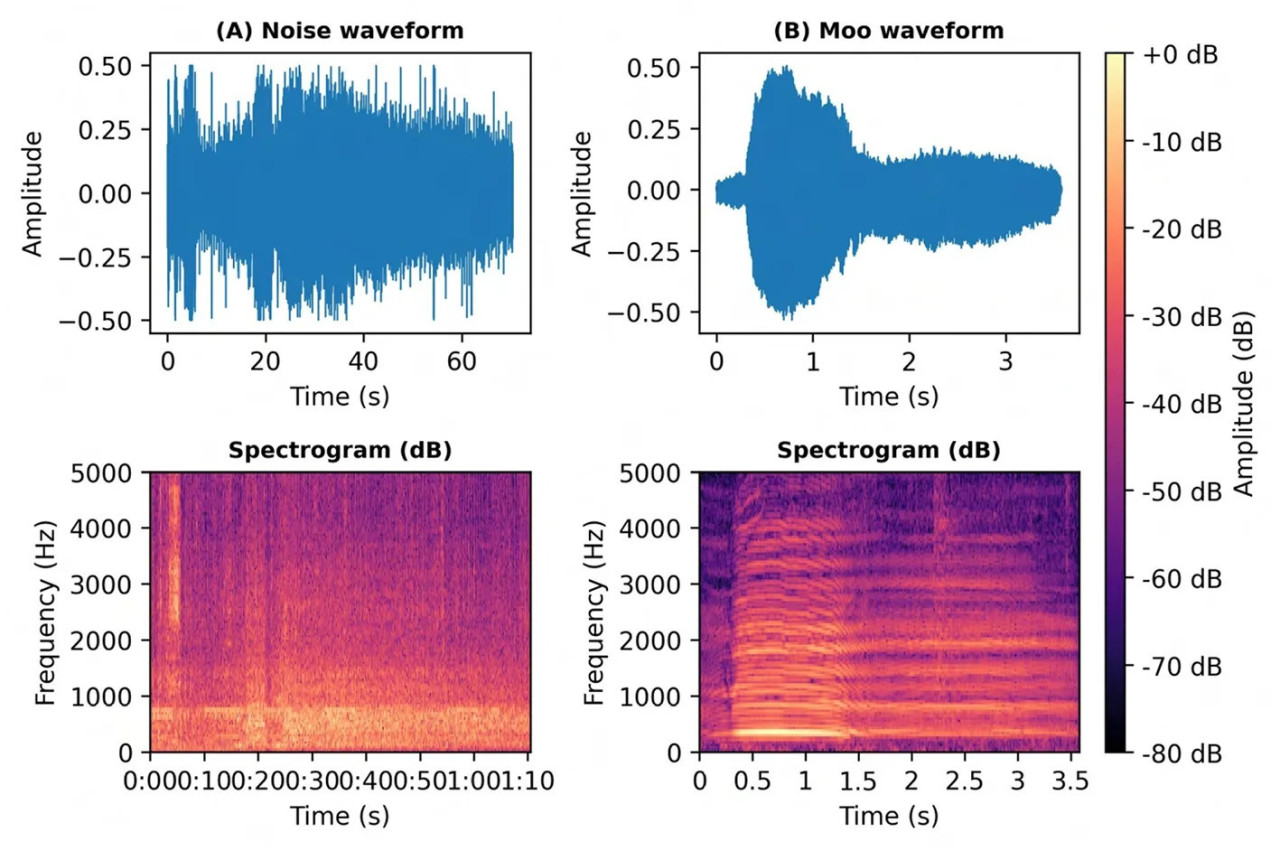
Рисунок 4 Сравнение спектрограмм шума коровника и вокализации коровы. (A) Осциллограмма и спектрограмма сегмента шума коровника, доминированного широкополосной механической и экологической энергией. (B) Осциллограмма и спектрограмма сигнала «му» коровы, записанного в той же акустической среде, показывающая гармонические стопки и полосы формант с периодическими энергетическими пиками. Спектрограммы вычислялись с использованием кратковременного преобразования Фурье и отображались в децибельной шкале относительно максимальной амплитуды для обеспечения прямого визуального сравнения спектральной структуры и чёткости сигнала.
4.2 Полосовая фильтрация
На основе результатов спектрального профилирования шума и известных частотных диапазонов вокализаций крупного рогатого скота был применён фильтр Баттерворта четвёртого порядка с частотами среза 50 Гц и 1800 Гц. Этот частотный диапазон был выбран для сохранения большей части вокальной энергии крупного рогатого скота — где фундаментальная частота обычно лежит между 100 и 300 Гц, а гармоники простираются до примерно 1000 Гц — при ослаблении низкочастотного гула механизмов ниже 50 Гц и высокочастотного электрического шипения выше 1800 Гц. Предыдущие исследования сообщали о сопоставимых диапазонах, отмечая, что вокализации крупного рогатого скота обычно демонстрируют фундаментальные частоты между 80 и 180 Гц для коров и телят, с энергией, простирающейся до 1 кГц или выше в определённых контекстах (de la Torre et al., 2015; Briefer, 2012; Lenner et al., 2025). Фильтр Баттерворта был выбран из-за его максимально плоской частотной характеристики в полосе пропускания, что избегает искажения гармонической структуры и сохраняет акустическую точность. Его использование хорошо установлено в акустических и биоакустических исследованиях как надёжный метод изоляции биологически релевантных частотных полос (MacCallum et al., 2011; Simmons et al., 2022). Для устранения фазовых сдвигов, которые могли бы повлиять на последующее извлечение акустических признаков, таких как контур высоты тона или анализ спектральной энергии, фильтрация была реализована с использованием нулево-фазовой прямо-обратной фильтрации с функциями butter и filtfilt из библиотеки scipy.signal Python.
Этот этап фильтрации играет критическую роль в конвейере предобработки. Подавляя спектральную энергию вне полосы вокализаций, он снижает широкополосные помехи и делает гармонические паттерны вокализаций более чёткими на спектрограммах. Это особенно важно в средах коровника, где фоновый шум от систем вентиляции, металлического лязга и роботизированных доильных механизмов часто перекрывается с вокальными частотами в диапазоне 50–1800 Гц. Хотя некоторое перекрытие остаётся, полосовая фильтрация существенно улучшает отношение сигнал/шум, подчёркивая стабильные форманты вокализаций коров, которые наиболее выражены между 200 и 400 Гц (Watts and Stookey, 2000; Green et al., 2019).
Процесс фильтрации также генерирует два выхода. Во-первых, данные спектрограмм экспортируются в виде CSV-файла, предоставляя частотные бины во времени в табличной форме, что позволяет автоматически обнаруживать вокальные события, такие как мычания, чихания или кашли, без непрерывного ручного прослушивания. Во-вторых, создаются отфильтрованные аудиофайлы WAV, которые представляют уменьшенное фоновое шипение и гул и поэтому облегчают более чистое прослушивание и ручное аннотирование. В совокупности эти выходы обеспечивают как слышимую человеком, так и машиночитаемую основу для последующих этапов анализа.
Хотя этот этап не полностью устраняет перекрывающийся шум коровника в полосе вокализаций, он существенно улучшает чёткость и подготавливает аудио для дальнейшей визуализации, маркировки и извлечения признаков. Сравнение спектрограмм до и после фильтрации (Рисунок 5) иллюстрирует подавление широкополосного шума при сохранении гармонической структуры сигналов коров.
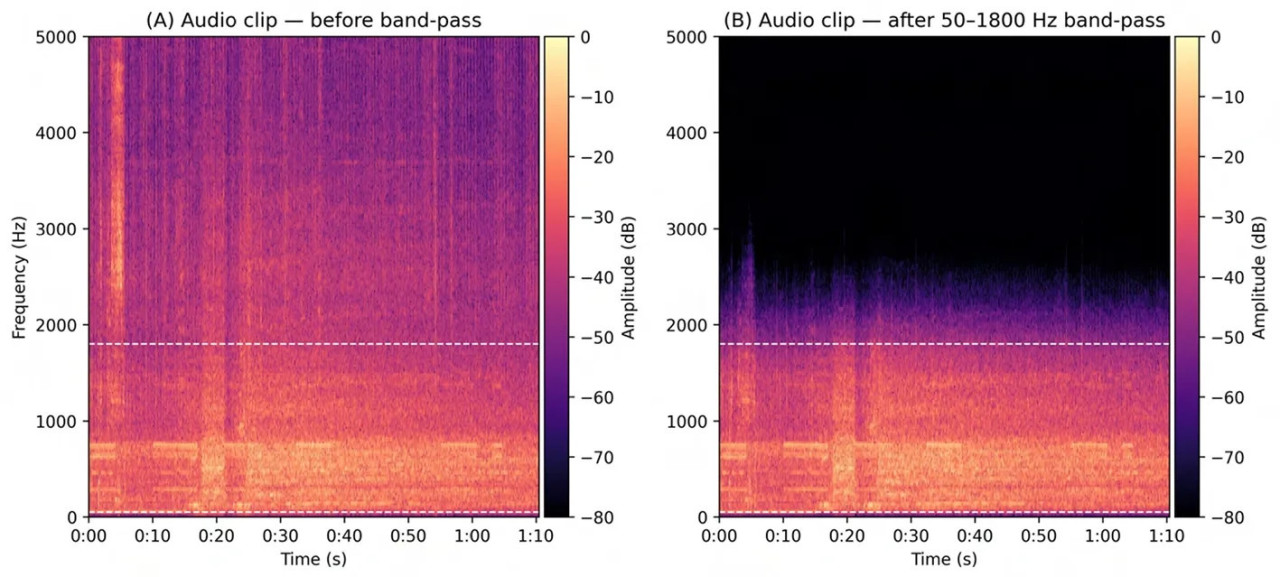
Рисунок 5 Влияние полосовой фильтрации на аудиоклип. (A) Спектрограмма нефильтрованного сигнала, показывающая широкополосную энергию, включая низкочастотный гул и высокочастотное шипение. (B) Спектрограмма после полосовой фильтрации 50–1800 Гц с чётким ослаблением энергии ниже 50 Гц и выше 1,8 кГц при сохранении внутриполосной гармонической структуры. Пунктирные линии обозначают полосу пропускания; обе панели имеют идентичные оси времени и частоты (отображаемые до 5 кГц) и общую цветовую шкалу дБ для прямого визуального сравнения.
4.3 Шумоподавление в iZotope RX 11
После полосовой фильтрации дополнительное подавление шума выполнялось с использованием iZotope RX 11 (iZotope Inc., Кембридж, Массачусетс), профессионального пакета восстановления аудио, который предлагает мелкозернистое спектральное редактирование, адаптивное изучение шума и модули исправления ошибок. Хотя iZotope RX ещё не цитируется в опубликованных биоакустических исследованиях, его функциональность параллельна классическим методам спектрального шумоподавления и восстановления, давно используемым в исследованиях звуков животных (например, спектральное вычитание, MMSE-спектральные оценки, вейвлет-шумоподавление) (Xie et al., 2021; Brown et al., 2017; Juodakis and Marsland, 2022). Совсем недавно такие методы, как Biodenoising, приняли высококачественное предварительное шумоподавление (часто с помощью речевых или спектральных инструментов) в качестве псевдочистых эталонов для обучения моделей, специфичных для животных, что дополнительно подтверждает использование продвинутых инструментов шумоподавления на предыдущих этапах. RX 11 был выбран потому, что он позволяет пользователю визуально inspect время-частотную структуру, выбирать области только шума, строить адаптивные профили шума и недеструктивно вычитать шум при сохранении интересующих вокальных гармоник. Эта гибкость особенно полезна в условиях коровника, где шум гетерогенен (например, гул вентиляции, механические лязги, электрическое шипение) и перекрывается по частоте с вокальной энергией.
Мы реализовали многоэтапный конвейер шумоподавления, состоящий из следующих шагов:
- Нормализация усиления и удаление DC-смещения для стандартизации амплитудных базовых уровней across записей.
- Спектральное шумоподавление для вычисления адаптивных оценок шума из тихих (невокальных) сегментов и их вычитания из сигнала.
- Спектральное восстановление для смягчения переходных артефактов (например, хлопков ворот или быстрых механических щелчков) путём интерполяции через отсутствующие время-частотные бины.
- Модули De-clip и De-crackle для коррекции случайного насыщения и импульсных шумовых событий.
- EQ Match для сглаживания общей частотной характеристики и компенсации окраски микрофона, что приводит к более естественному тональному балансу.
Этот конвейер дал заметное улучшение отношения сигнал/шум, так что вокализации коров стали более различимыми на спектрограммах, с более чистой гармонической непрерывностью и меньшим количеством артефактных прерываний. Повышенная чёткость помогает как ручному аннотированию, так и нижестоящей сегментации или извлечению признаков. Скриншот интерфейса RX 11, показывающий сеанс спектрального редактирования (Рисунок 6), визуально демонстрирует, как шум изолируется и удаляется при сохранении вокальной структуры. Хотя подход не полностью устраняет перекрывающийся шум в вокальной полосе, он значительно снижает помехи и закладывает основу для надёжного обнаружения событий и анализа признаков.
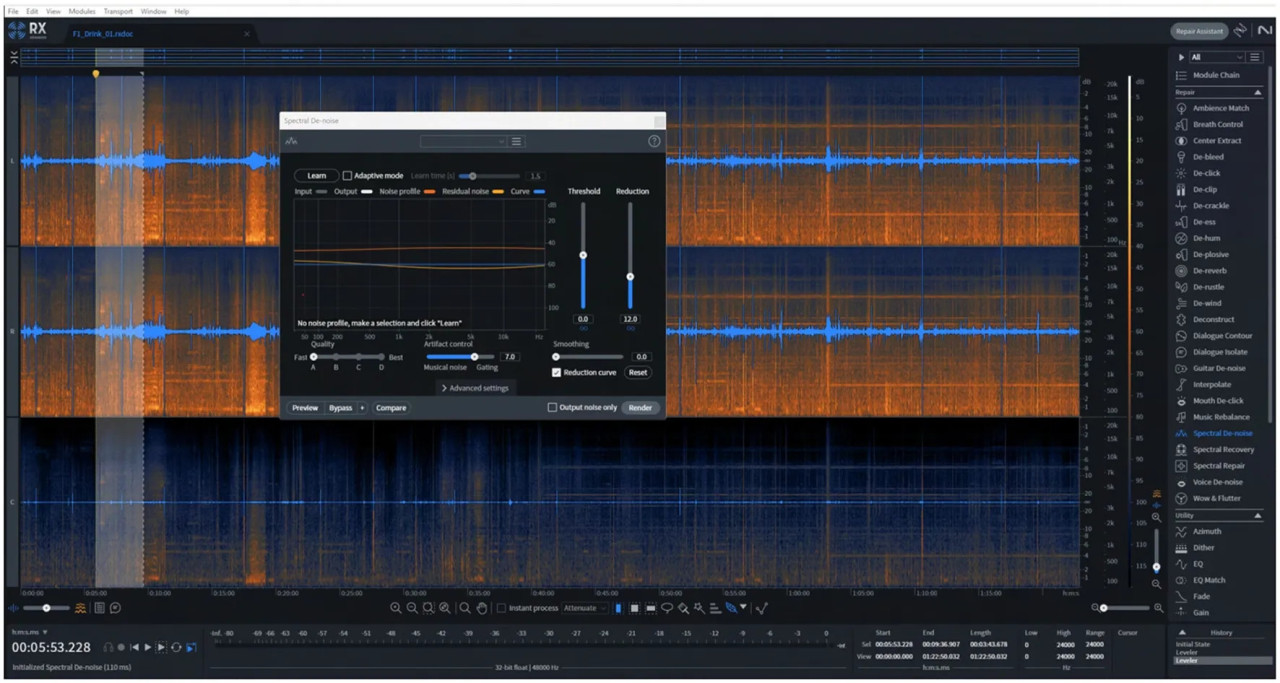
Рисунок 6 Спектральное шумоподавление вокализации коровы в iZotope RX. Скриншот из iZotope RX (модуль Spectral Denoise), показывающий рабочий процесс шумоподавления, применённый к исходному аудио коровника перед извлечением признаков. (Верхняя панель) отображает исходную спектрограмму с широкополосным фоновым шумом, типичным для гула вентилятора и механизмов, тогда как (нижняя панель) показывает очищенный сигнал после адаптивного спектрального вычитания. Оценка профиля шума выполнялась с использованием сегмента только шума, а настройки ослабления были настроены для сохранения вокальных гармоник при подавлении стационарного низкочастотного шума и высокочастотного шипения. Этот этап предобработки повысил отношение сигнал/шум и обеспечил более чёткие спектральные признаки для последующего анализа.
Поскольку iZotope RX 11 является проприетарным программным обеспечением, мы реализовали полностью открытый Python-конвейер, который близко аппроксимирует этот многоэтапный рабочий процесс и может выполняться без коммерческих инструментов. Начиная с отфильтрованного аудио, описанного в Разделе 4.2, скрипт Python выполняет:
- Нормализацию усиления и удаление DC-смещения: аудио загружается, среднее вычитается для удаления DC-смещения, и уровни нормализуются по пику или громкости до согласованного, не клиппирующего диапазона.
- Широкополосное спектральное шумоподавление: нестационарное спектральное стробирование с noisereduce ослабляет фоновый шум коровника, используя сегменты только шума, когда они доступны, или адаптивную оценку шума в противном случае, с умеренной силой снижения для сохранения вокальных гармоник.
- Спектральное восстановление переходных артефактов: короткие широкополосные переходные процессы (например, металлические удары, щелчки) обнаруживаются в STFT-области librosa и локально ослабляются или сглаживаются во время-частотном представлении.
- Опциональное de-clip и de-crackle: клиппированные пики реконструируются путём интерполяции между неклиппированными соседями, а мелкий импульсный треск снижается с помощью простой медианной фильтрации, применяемой только при наличии явных дефектов записи.
- Согласование спектральной огибающей / EQ: средние спектры магнитуды каждого клипа сопоставляются с нейтральным эталоном с использованием частотно-зависимой кривой усиления numpy, scipy.signal, что снижает окраску, зависящую от микрофона и размещения.
Этот пятиэтапный рабочий процесс обеспечивает прозрачную, полностью воспроизводимую альтернативу цепочке RX 11; хотя реализация на Python следует той же философии обработки и последовательности, отдельные выходные осциллограммы не будут совпадать с результатами RX 11 выборка за выборкой и могут незначительно отличаться по остаточному шуму и тембру. Полная реализация на Python и детали конфигурации для этого конвейера доступны в репозитории GitHub, указанном в Заявлении о доступности данных.
4.4 Сегментация с Raven Lite и акустическая инспекция в Praat
После шумоподавления в iZotope RX 11 мы сегментировали непрерывные записи на отдельные вокализации с использованием Raven Lite (версия 2.0). Raven Lite — это бесплатный инструмент акустического анализа, разработанный Лабораторией орнитологии Корнеллского университета и широко применяемый в экологических и поведенческих биоакустических исследованиях (Dugan et al., 2016). Raven Lite был выбран потому, что он обеспечивает визуализацию осциллограмм и спектрограмм в реальном времени с простыми инструментами выбора для ручного клиппинга и экспорта, и он свободно доступен и широко используется в биоакустических рабочих процессах. Хотя ему не хватает автоматического обнаружения и функций пакетной обработки, доступных в Raven Pro, он хорошо подходил для контекстно-зависимой ручной сегментации, требуемой в этом исследовании.
Мы настроили Raven Lite для отображения спектрограммы кратковременного преобразования Фурье (STFT) с окном на 1024 точки, 50% перекрытием и окном Хэмминга (Рисунок 7), что обеспечивает практический баланс между временным и частотным разрешением для сигналов крупного рогатого скота. Кандидатные события идентифицировались путём визуального сканирования спектрограммы на наличие гармонических стопок или широкополосных всплесков и подтверждения каждого события прослушиванием. Затем каждый клип извлекался с маркерами начала и конца, и включались 2–3 с отступа с каждой стороны для сохранения контекстных подсказок (например, вдох перед началом, резонансные хвосты). Начало отмечалось там, где амплитуда поднималась выше уровня шума и становилась видимой первая гармоническая полоса; конец отмечался там, где энергия возвращалась к базовому уровню — критерии, соответствующие общей практике биоакустической сегментации в исследованиях вокализаций животноводства (Meen et al., 2015).
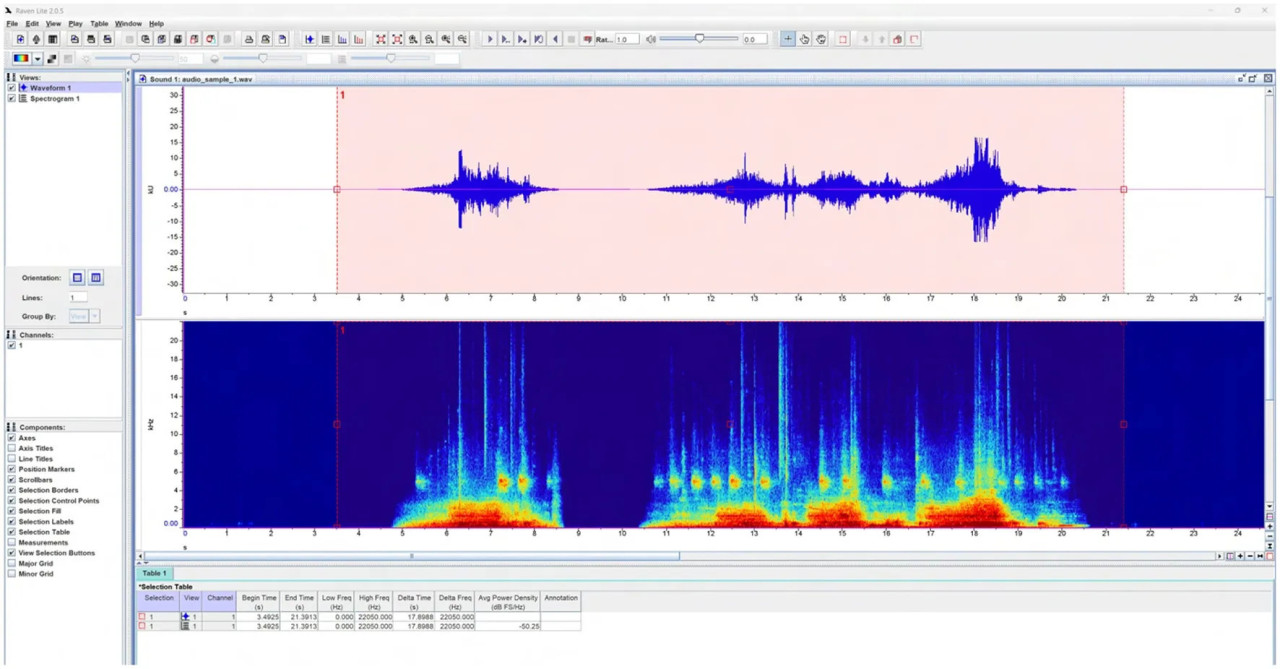
Рисунок 7 Аннотирование вокализаций коров с использованием Raven Lite. Скриншот из Raven Lite, показывающий ручное аннотирование сегментов вокализаций на виде спектрограммы. Каждый прямоугольник выбора соответствует идентифицированному событию сигнала, с отмеченными временами начала и конца на основе видимых гармонических границ начала и конца. Эта визуальная проверка обеспечивала точную сегментацию вокализаций и исключение механического или экологического шума. Аннотированные время-частотные области позже использовались в качестве эталонных интервалов для автоматизированного извлечения признаков и маркировки в Python.
Для поддержания прослеживаемости каждый выбор экспортировался как новый файл WAV и именовался по структурированному соглашению, кодирующему ферму, зону, дату, время, микрофон и временный заполнитель класса. Из 90 ч записей было извлечено примерно 569 клипов. Для снижения субъективности независимый второй аннотатор перекрёстно проверял подмножество клипов на размещение границ и полноту (межнаблюдательная калибровка), и мы приняли консервативную политику сохранения дополнительных секунд контекста в случае неопределённости.
После клиппинга мы выполняли акустическую инспекцию в Praat (Boersma, 2011) для проверки границ сегментации и подтверждения того, что выборки представляют подлинные вокализации, а не остаточный шум или механические переходные процессы (Green et al., 2019). В Praat (Рисунок 8) мы инспектировали контуры высоты тона (F0) и треки формант (F1, F2) вместе с огибающими интенсивности, чтобы проверить, что гармоническая структура непрерывна в пределах отмеченных границ и соответствует ожиданиям вокальной продукции крупного рогатого скота, сообщённым в предыдущих работах. Затем мы связали Praat с Python через Parselmouth (Jadoul et al., 2018) для скриптового извлечения нативных для Praat мер (например, диапазон высоты тона, форманты, отношение гармоник к шуму), и дополнили их признаками librosa (например, спектральный центроид, полоса пропускания, срез, частота переходов через ноль) для машиночитаемых дескрипторов, используемых позже в моделировании. Эта комбинация обеспечивала согласованность между проверенными человеком границами и алгоритмическими признаками.
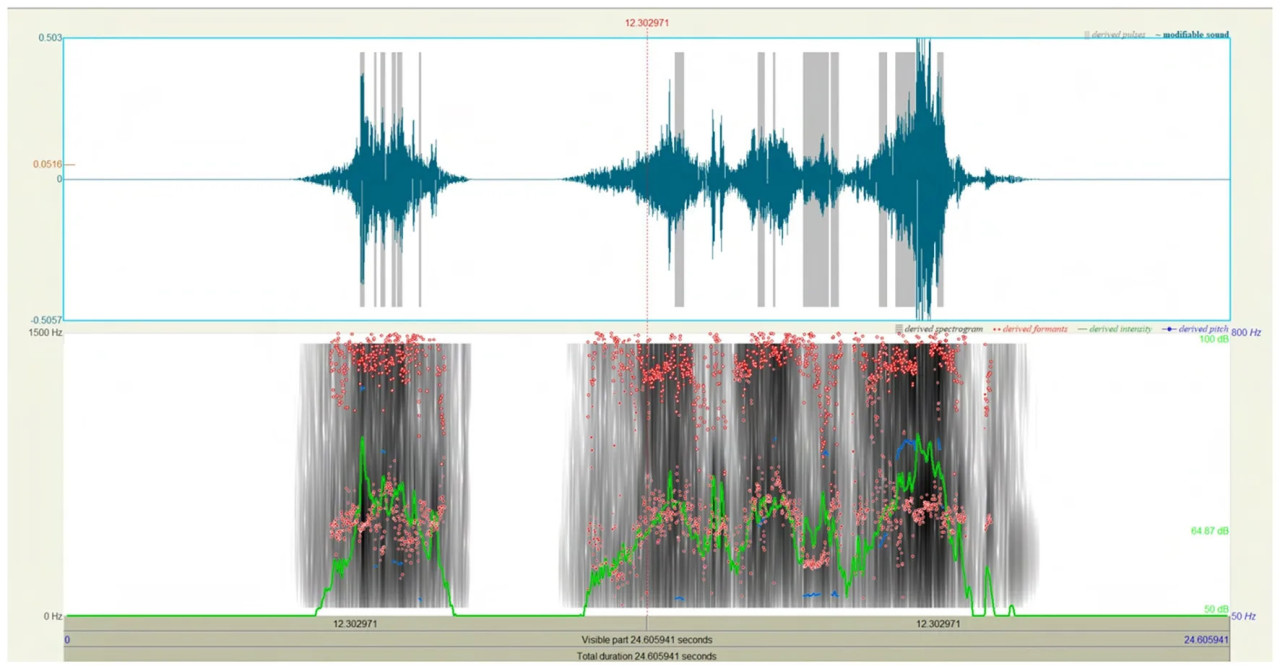
Рисунок 8 Акустическая инспекция и верификация признаков в Praat. Скриншот из Praat, показывающий осциллограмму, спектрограмму, контур высоты тона (F0), треки формант (F1–F2) и огибающую интенсивности для репрезентативной вокализации коровы. Визуальная инспекция в Praat использовалась для проверки границ сегментации и подтверждения того, что выборки представляют подлинные вокальные события, а не фоновые переходные процессы. Непрерывная гармоническая структура и ожидаемые траектории формант проверялись на соответствие известным паттернам вокальной продукции крупного рогатого скота, гарантируя, что аннотированные клипы отражают валидное поведение сигнала перед автоматизированным извлечением признаков и моделированием.
Сильные стороны Raven Lite на этом этапе — его стабильность, чёткий интерфейс спектрограмм и низкие операционные издержки для ручной, контекстно-зависимой сегментации; ограничения включают отсутствие пакетного аннотирования и продвинутых детекторов, которые существуют в Raven Pro и в исследовательском коде. По мере расширения набора данных мы ожидаем масштабирования с помощью полуавтоматических детекторов (например, конвейеров HMM/ML или инструментов обнаружения Raven Pro), как показано в связанных исследованиях обнаружения вокализаций крупного рогатого скота. Однако для настоящей работы ручная сегментация с консервативным отступом и кросс-валидацией создала корпус с высокой уверенностью, подходящий для нижестоящего извлечения признаков и анализа.
Чтобы количественно оценить, насколько последовательно этот протокол аннотирования может применяться независимыми наблюдателями, мы провели исследование межаннотаторного согласия на стратифицированном подмножестве клипов, как описано в Разделе 4.5.
4.5 Межаннотаторное согласие и надёжность
Для оценки надёжности поведенческих и акустических меток, применённых к кураторским клипам, мы провели исследование межаннотаторного согласия на стратифицированном подмножестве из 150 аудиоклипов. Подмножество было выбрано так, чтобы охватить все девять основных поведенческих категорий, используемых в этом исследовании, и полный набор из 48 подкатегорий, обеспечивая представление across разнообразных вокальных типов и контекстов коровника. Каждый клип в этом подмножестве независимо аннотировался двумя обученными наблюдателями, следующими тем же руководящим принципам, что описаны в Разделе 4.6, включая назначение основной категории, подкатегории и связанных контекстных заметок.
Статистика согласия вычислялась на Python с использованием pandas и функции cohen_kappa_score из scikit-learn для номинальных меток. Сводка межаннотаторной надёжности для меток основных и подкатегорий представлена в Таблице 5. Для основных поведенческих категорий (9 классов) прямое сравнение между Аннотатором 1 и Аннотатором 2 дало коэффициент κ Коэна 0,884 с 90,0% сырого согласия по 150 клипам, указывая на высокую согласованность в назначении широких поведенческих классов. Для более мелкозернистых подкатегорий (48 классов) межрейтинговое согласие оставалось существенным: κ = 0,699 и 71,3% сырого согласия.
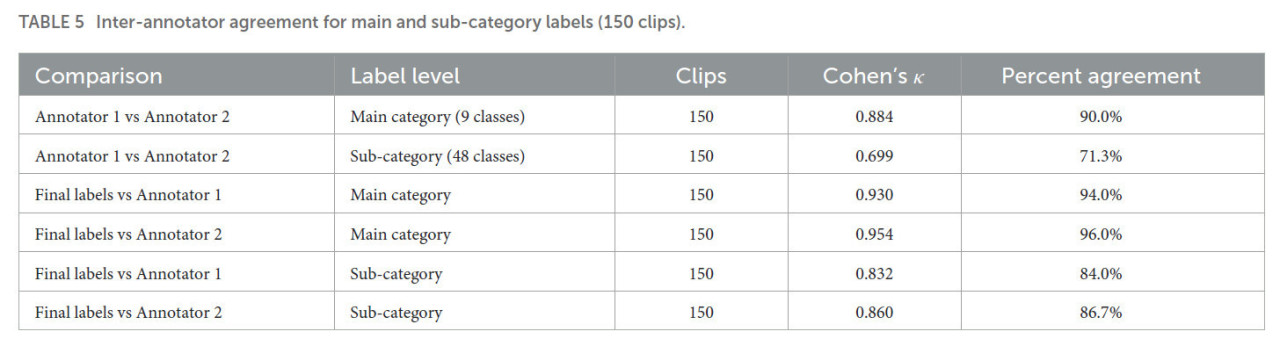
Таблица 5 Межаннотаторное согласие для меток основных и подкатегорий (150 клипов).
Мы также оценили согласие между каждым аннотатором и финальными консенсусными метками, которые представляют собой вынесенные «золотые стандартные» аннотации, используемые в выпущенном наборе данных. Консенсусные метки («Main Category final» и «Sub Category final») были получены путём совместного обзора обоими аннотаторами и ведущим исследователем со ссылкой на спектрограммы, огибающие осциллограмм, метаданные и совместно записанное видео, где это было доступно. Для основных категорий согласие между финальными метками и Аннотатором 1 составило κ = 0,930 (94,0% согласия), а между финальными метками и Аннотатором 2 — κ = 0,954 (96,0% согласия). Наиболее запутанные пары показаны в Дополнительных рисунках S1, S2. Эти результаты надёжности подтверждают, что финализированные метки обеспечивают стабильную эталонную истину для последующего аннотирования первого уровня и нижестоящих поведенческих анализов.
4.6 Аннотирование первого уровня
Каждый сегментированный клип подвергался аннотированию первого уровня двумя исследователями, которые назначали несколько меток, отражающих тип сигнала, эмоциональный контекст и уверенность, а также поведенческую сводку. Конкретно, для каждого клипа аннотатор записывал:
- Основную категорию и подкатегорию согласно схеме, определённой в Разделе 2.4, основанной на этологических типологиях вокального поведения;
- Метку эмоционального контекста (дистресс, боль, предвкушение, голод), отражающую предполагаемое аффективное состояние на момент вокализации;
- Оценку уверенности (1 = низкая до 10 = высокая), указывающую на уверенность аннотатора в своей маркировке;
- Текстовое описание, суммирующее наблюдаемые поведенческие подсказки или ситуационный контекст (например, «телёнок стоит возле поилки», «корова ждёт у кормовых ворот», «проходит мимо доильного зала»).
Границы начала и конца дополнительно уточнялись в Praat, чтобы использовать его высокоточное измерение времени и возможности отображения высоты тона/формант, позволяя аннотаторам точно настраивать временные пределы сигналов. Руководящие принципы аннотирования опирались на этологические принципы: сигналы должны были быть связаны с проксимальными стимулами (например, кормление, разлука, disturbance) и рассматриваться в свете возможных конечных функций (например, контакт, дистресс, solicitation). В неоднозначных случаях или при перекрывающихся сигналах назначалась метка «Unknown» для последующего обзора, а не принудительная классификация. Аннотаторы также консультировались с ручными заметками и совместно записанным видео, где это было доступно, для подтверждения поведенческого контекста (например, проверка, кормилась ли корова или проявляла фрустрацию). Выход этого этапа — кураторский набор помеченных аудиоклипов, каждый с категорией, эмоциональной валентностью, уверенностью и поведенческим описанием, готовый для нижестоящего извлечения признаков и статистического моделирования.
При определении типа сигнала аннотаторы полагались на спектро-временную форму (например, гармонические стопки, частотную модуляцию, длительность сигнала), амплитудную огибающую и контекст. Например, низкочастотные сигналы со стабильными гармониками могли быть отнесены к категориям контакта или низкого возбуждения, тогда как сигналы с резким началом, быстрой модуляцией или высокой спектральной энергией могли указывать на ажитацию или сигналы тревоги. Эта практика соответствует литературе о вокализации крупного рогатого скота как коммуникативных сигналах, несущих информацию о мотивации или аффекте (Green et al., 2018), и в более широком смысле о вокальном поведении как «этотрансмиттере» у млекопитающих (Brudzynski, 2013). В недавней работе по машинному обучению (например, Gavojdian et al., 2024, «BovineTalk») сигналы крупного рогатого скота классифицируются на низкочастотные (LF) и высокочастотные (HF) типы — часто отображая LF на близкодействующие или нейтральные состояния, а HF на более срочные или негативные состояния — что даёт эмпирический прецедент нашим категориям аннотирования.
В summary, конвейер предобработки, который мы использовали — охватывающий количественное профилирование шума, целевую фильтрацию, профессиональное шумоподавление, тщательную сегментацию и это строгое, контекстно-зависимое аннотирование — решает проблемы шумных сред коровника и создаёт высококачественный, хорошо документированный корпус вокализаций. Этот корпус формирует надёжную основу для извлечения признаков и последующего машинного обучения или статистического моделирования. После предобработки и начального аннотирования мы приступили к компиляции набора данных через извлечение признаков, биологическую интерпретацию, компиляцию метаданных и исследовательский анализ.
5 Создание набора данных
5.1 Извлечение акустических признаков
После того как сегментированные клипы прошли аннотирование первого уровня, мы извлекли комплексный набор из 24 акустических признаков для характеристики каждой вокализации, как суммировано в Таблице 6. Вычисление признаков выполнялось с использованием комбинации Praat, Parselmouth, librosa и openSMILE, представляющих как традиционные фонетические инструменты, так и современные библиотеки обработки сигналов. Признаки охватывали временную, спектральную и кепстральную области с целью фиксации как биологически интерпретируемых мер, так и машиночитаемых дескрипторов, обычно используемых в биоакустических исследованиях животных (Meen et al., 2015; de la Torre et al., 2015).
- Временные метрики включали время начала, время конца и длительность сигнала. Длительность неоднократно связывалась с возбуждением и мотивационным состоянием: более короткие сигналы чаще связаны с нейтральными или положительными контекстами, тогда как более длинные сигналы обычно отражают более высокое возбуждение или негативные состояния (Brudzynski, 2013).
- Качество сигнала количественно оценивалось с использованием отношения сигнал/шум (SNR), позволяя оценить, насколько чётко вокализация выделялась из среды коровника. Клипы с высоким SNR обеспечивают более надёжное измерение признаков и нижестоящее моделирование.
- Фундаментальная частота (F0) измерялась с использованием метода автокорреляции Praat, со статистикой среднего, минимального и максимального F0, вычисленной для каждого клипа. Вокализации крупного рогатого скота обычно находятся между 50 и 1250 Гц, со средними значениями 120–180 Гц. Высокочастотные сигналы около 150 Гц связывались с дистрессом разлуки, тогда как низкочастотные назальные сигналы около 80 Гц связаны с близким контактом и успокаивающими социальными функциями (Watts and Stookey, 2000; Green et al., 2018; Gavojdian et al., 2024).
- Статистика интенсивности (минимальная и максимальная дБ) фиксировала вариацию между тихими и сильными сигналами. В соответствии с предыдущими находками, сигналы более высокой интенсивности часто указывают на срочность или фрустрацию, тогда как более низкие интенсивности соответствуют спокойным аффилиативным контекстам (Watts and Stookey, 2000).
- Частоты формант (F1, F2) оценивались с использованием метода Берга Praat. Форманты представляют резонансы голосового тракта и дают подсказки о размере тела и форме голосового тракта (Fitch and Hauser, 2003). У крупного рогатого скота F1 и F2 документированы в диапазонах между ~228 и 3181 Гц, со средними длительностями сигналов ~1,2 с (de la Torre et al., 2015).
- Полосовые метрики извлекались с использованием librosa, включая полосу пропускания, RMS-энергию (среднее и стандартное отклонение), спектральный центроид, спектральную полосу пропускания, спектральный срез (85/95), частоту переходов через ноль (ZCR, среднее и стандартное отклонение) и время до пиковой энергии. Эти дескрипторы суммируют распределение энергии и шумность сигнала. Например, высокие значения спектрального центроида соответствуют более ярким, более шумным событиям (например, металлические звуки коровника, фырканья), тогда как более низкие значения центроида характерны для гармонических мычаний.
- Мел-частотные кепстральные коэффициенты (MFCC) (первые 13 коэффициентов: среднее и стандартное отклонение) вычислялись с использованием librosa и openSMILE. MFCC обеспечивают компактное представление вокального тембра и широко используются в классификации сигналов животных, включая вокализации крупного рогатого скота (Schrader and Hammerschmidt, 1997; Sattar, 2022).
- Наконец, вычислялось отношение voiced, представляющее долю кадров, классифицированных как voiced vs. unvoiced. Высокочастотные сигналы дистресса часто демонстрируют больше unvoiced кадров из-за расширения голосовой щели и турбулентного воздушного потока, тогда как назальные низкочастотные мычания обычно полностью voiced (Briefer, 2012).
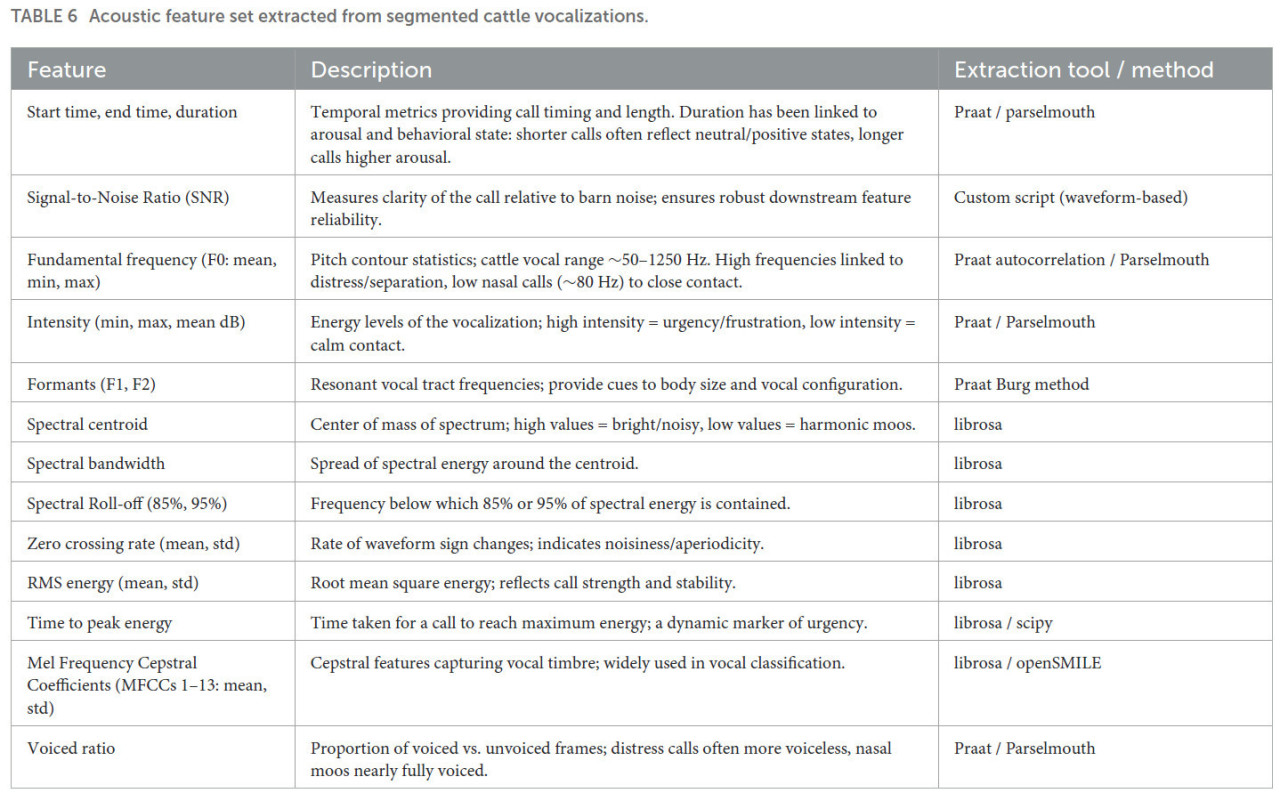
Таблица 6 Набор акустических признаков, извлечённых из сегментированных вокализаций крупного рогатого скота.
Все признаки извлекались с частотой дискретизации 16 кГц (с понижением от 44,1/48 кГц), что сохраняло релевантную вокальную полосу пропускания крупного рогатого скота при снижении вычислительной нагрузки.
Помимо численного вычисления, эти признаки имеют биологическое значение, которое мы интерпретируем в следующем подразделе.
5.2 Биологическая интерпретация акустических признаков
Выбранные признаки были выбраны не только из-за их статистической полезности в машинном обучении, но и из-за их биологической интерпретируемости. Этот двойной акцент гарантирует, что вычислительные модели остаются основанными на механизмах вокальной продукции крупного рогатого скота и их этологической значимости.
- Фундаментальная частота (F0) в первую очередь определяется длиной, натяжением и массой голосовых складок (Brudzynski, 2010). Повышения F0 обычно связаны с повышенным возбуждением, дистрессом разлуки или эструсом, тогда как более низкая F0 характерна для спокойных аффилиативных сигналов (Green et al., 2018; Röttgen et al., 2018). В нашем наборе данных сигналы, помеченные Estrus_Call и High_Frequency_Distress, демонстрировали как повышенную максимальную F0, так и большую вариабельность F0, что соответствует сообщениям о том, что самки крупного рогатого скота издают более высокотональные сигналы во время эструса или при разлуке с телятами. Напротив, низкочастотные назальные мычания, обычно около 80–120 Гц, чаще были связаны с аффилиативными контекстами или контекстами поиска контакта, echoing находки из исследований материнско-потомственной коммуникации (de la Torre et al., 2015).
- Частоты формант (F1, F2) отражают резонансы голосового тракта и передают информацию об артикуляционной конфигурации и размере тела (Fitch and Hauser, 2003). Более низкие значения формант связаны с открытием рта и большей длиной голосового тракта, тогда как более высокие форманты отражают положение языка и губ. В наших данных Water_Slurping_Sounds демонстрировали широкие полосы пропускания и высокое разделение F1–F2, фиксируя их шумную, негармоническую структуру, тогда как гармонические мычания показывали более плотную кластеризацию полос F1 и F2. Это наблюдение соответствует более ранним описаниям динамики формант в вокализациях крупного рогатого скота (Watts and Stookey, 2000).
- Энергетические меры (RMS-энергия, интенсивность и время до пика) дополнительно фиксировали динамическую и аффективную силу вокализаций. Высокая RMS-энергия и короткие значения времени до пика были заметны в Frustration_Calls и Aggressive_Bellows, отражая резкие, высокосиловые emissions. Напротив, Mother_Separation_Calls были ниже по интенсивности, но длиннее по продолжительности, представляя настойчивые вокальные усилия на более низких уровнях силы, в соответствии с наблюдениями сигналов разлуки у пар корова-телёнок (Green et al., 2019).
- Спектральные дескрипторы обеспечивали надёжное средство различения гармонических и шумных событий. Значения спектрального центроида и среза дифференцировали стабильные гармонические мычания от широкополосных невокальных звуков, таких как чихания, кашли или отрыжки. Эти невокальные события показывали повышенные значения центроида и частоты переходов через ноль, указывая на их шумный и апериодический характер (Meen et al., 2015).
- Наконец, мел-частотные кепстральные коэффициенты (MFCC) кодировали глобальную спектральную форму и оказались особенно полезными для различения тонких различий между похожими категориями, такими как Feed_Anticipation_Call и Feeding_Frustration_Call. Это согласуется с недавними применениями MFCC в мониторинге животноводства, где кепстральный анализ показал способность обнаруживать события эструса с точностью, превышающей 90% (Sattar, 2022; Gavojdian et al., 2024).
В совокупности эти ассоциации признаков и поведения подтверждают, что набор данных не только подходит для вычислительного моделирования, но и биологически значим. Привязывая машиночитаемые признаки к установленным этологическим рамкам (четыре вопроса Тинбергена; Dugatkin, 2020), подход гарантирует, что нижестоящая классификация и прогнозирование сохраняют релевантность для науки о благополучии животных и практического мониторинга молочных ферм.
Чтобы гарантировать, что каждый признак и аннотация прозрачны и повторно используемы, мы составили структурированную схему метаданных.
5.3 Компиляция метаданных и схема
Чтобы гарантировать, что каждый аудиоклип может быть однозначно идентифицирован, контекстуализирован и повторно использован для дальнейших исследований, мы разработали комплексную схему метаданных для сопровождения кураторского набора данных (Таблица 7). Схема интегрирует идентификаторы, контекстные дескрипторы, акустические параметры, поведенческие аннотации и экологические меры, тем самым соответствуя лучшим практикам кураторства данных по геномике животных и поведенческих данных, изложенным консорциумом FAANG (Harrison et al., 2018) и принципами данных FAIR.
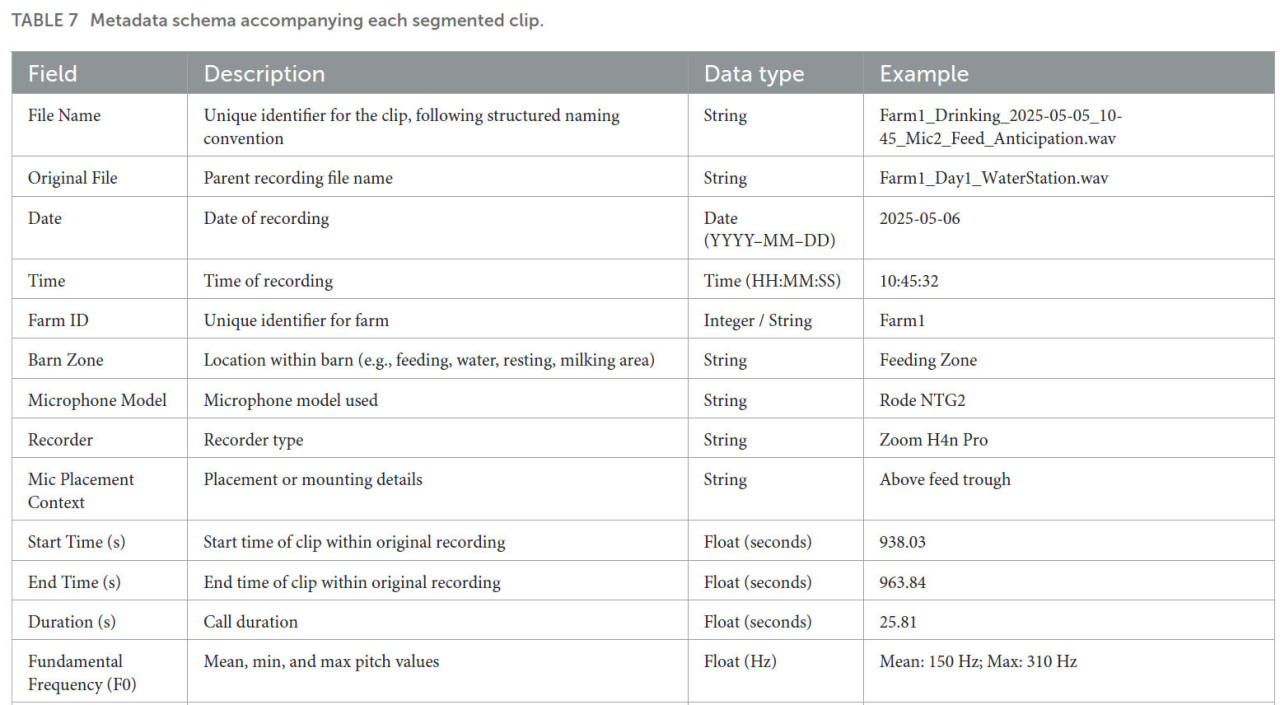
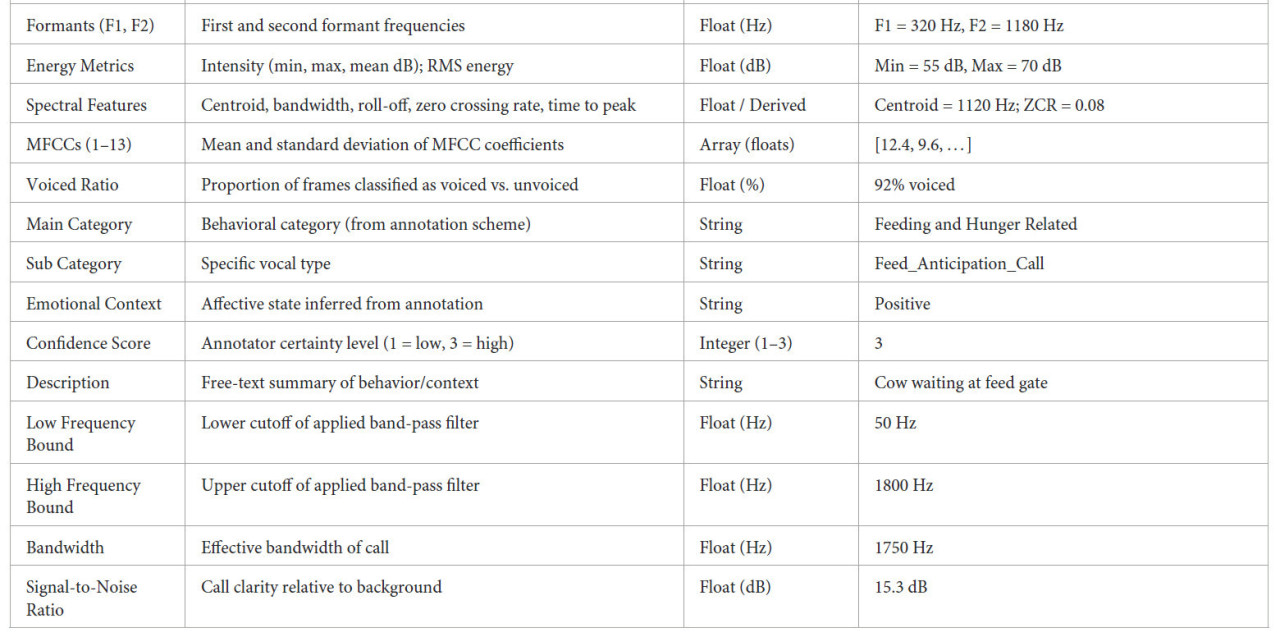
Таблица 7 Схема метаданных, сопровождающая каждый сегментированный клип.
Поля метаданных были структурированы в пять категорий:
- Идентификаторы файлов: каждому клипу присваивается уникальное имя файла по структурированному соглашению, которое кодирует идентификатор фермы, зону записи, дату, время, идентификатор микрофона и временный тип сигнала. Дополнительные поля включают имя исходного файла записи и точные отметки даты-времени.
- Контекстная информация: эти поля фиксируют среду записи и инструментарий, включая идентификатор фермы, зону коровника (например, кормовая зона, водная станция, зона отдыха, доильный зал), модель микрофона, тип рекордера и контекст размещения микрофона. Такие метаданные обеспечивают интерпретируемость в гетерогенных средах коровника (Meen et al., 2015).
- Акустические признаки: включён полный набор из 24 акустических признаков, описанных в Разделе 5.1 — включая длительность, статистику F0, значения формант, меры интенсивности, спектральный центроид, полосу пропускания, срез, RMS-энергию, частоту переходов через ноль, статистику MFCC, отношение voiced и время до пиковой энергии. Хранение этих признаков непосредственно в таблице метаданных позволяет быстрое подмножествование и анализ без повторного запуска конвейеров извлечения.
- Поведенческие аннотации: каждый клип связан со схемой аннотирования, описанной в Разделе 4.6. Поля включают основную категорию и подкатегорию (например, Feeding_Anticipation_Call, Mother_Separation_Call, Burp), эмоциональный контекст (дискомфорт, боль, голод, жажда), оценку уверенности аннотатора (1–10) и свободное текстовое описание, суммирующее поведенческие подсказки (например, «телёнок стоит возле поилки», «корова ждёт у кормовых ворот»). Это двойное аннотирование — структурированные категории плюс свободные заметки — позволяет как количественный, так и качественный анализ.
- Экологические параметры: для документирования условий записи и этапов предобработки метаданные также включают низко- и высокочастотные срезы полосового фильтра (Раздел 4.2), эффективную полосу пропускания, отношение сигнал/шум и настройки усиления микрофона, где это доступно. Эти параметры критичны для воспроизводимости, учитывая вариабельность акустических сред коровника (Alsina-Pagès et al., 2021).
Таким образом, схема метаданных поддерживает практики данных Findable, Accessible, Interoperable и Reusable (FAIR), предоставляя чёткие идентификаторы, структурированные дескрипторы и машиночитаемые акустические метрики. Для иллюстрации в Таблицах 8, 9 представлены три репрезентативные записи метаданных: Feed_Anticipation_Call, записанный в зоне кормления, Mother_Separation_Call в зоне отдыха и Burp в зоне кормления. Эти примеры демонстрируют, как поведенческие категории, контексты записи и акустические профили (например, различия в длительности, максимумах F0, интенсивности и дисперсии формант) прозрачно документируются.
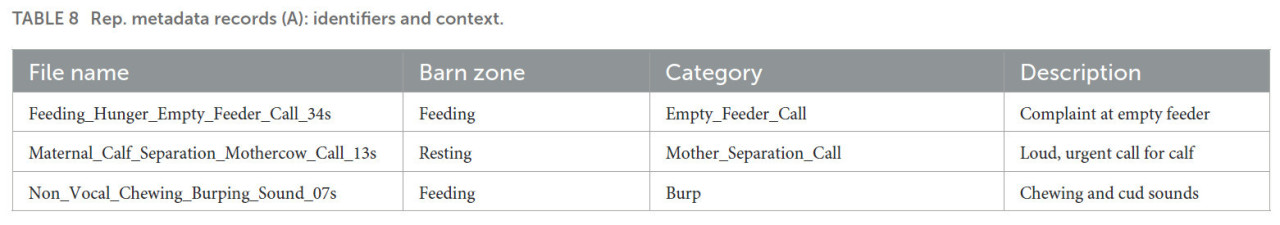
Таблица 8 Репрезентативные записи метаданных (A): идентификаторы и контекст.
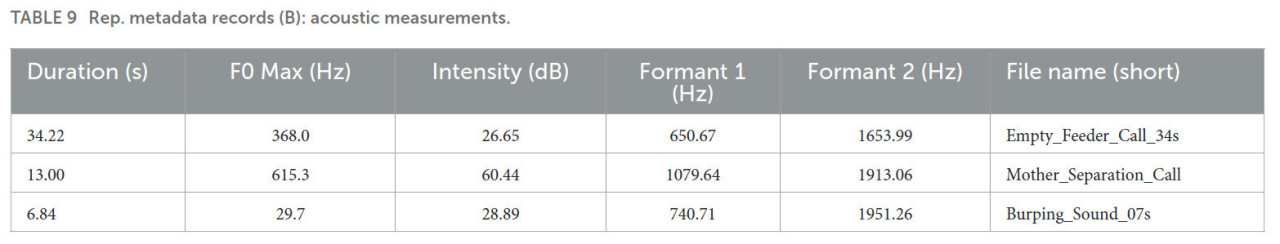
Таблица 9 Репрезентативные записи метаданных (B): акустические измерения.
Компилируя как биологические, так и технические дескрипторы, метаданные не только позволяют эффективное подмножествование корпуса (например, по поведению, среде или акустическому свойству), но и обеспечивают долгосрочную воспроизводимость и совместимость с другими биоакустическими наборами данных животноводства.
5.4 Распределение классов, аугментация и балансировка классов
Финальный кураторский набор данных включает 569 аудиоклипов, охватывающих 48 поведенческих классов. Каждый клип представляет собой шумоподавлённую вокализацию или невокальный звук с точными границами начала и конца. Средняя длительность составляет ~21 с (медиана ~13,8 с; диапазон 2,8–445 с), при этом ~75% клипов короче 21 с. Исходное распределение классов сильно длиннохвостое: небольшое число типов поведения (например, сигналы эструса, сигналы предвкушения кормления и респираторные звуки) составляют большую долю клипов, тогда как многие классы представлены менее чем 10 примерами. Этот паттерн отражает как истинную частоту поведений на ферме, так и практическую трудность фиксации редких событий. Длиннохвостое распределение иллюстрируется гистограммой и диаграммами Парето на Рисунках 9, 10. По сравнению с более ранними наборами данных вокализаций крупного рогатого скота [например, 1144 сигнала от 20 изолированных коров (Gavojdian et al., 2024), или 290 сигналов в четырёх физиологических состояниях (Yoshihara and Oya, 2021)], наш корпус шире по охвату, охватывая несколько ферм, зон коровника, высоко- и низкочастотные сигналы и невокальные события. Асимметричные распределения распространены в биоакустике животных (Kahl et al., 2021) и представляют хорошо документированные проблемы для моделей машинного обучения, которые могут переобучаться на частых классах и показывать низкую производительность на редких, но этологически значимых категориях (Johnson and Khoshgoftaar, 2019).
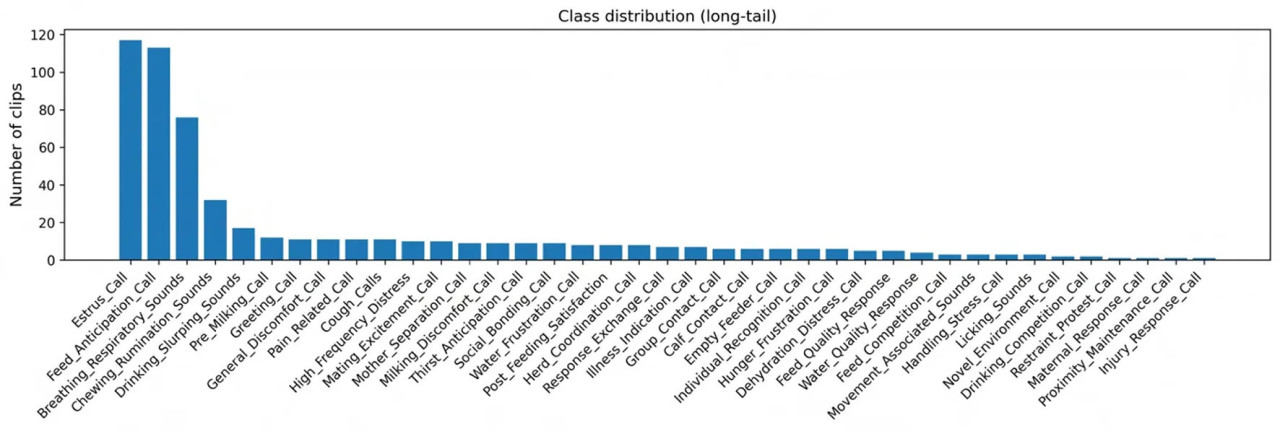
Рисунок 9 Общее распределение классов вокализаций коров. Длиннохвостое распределение всех аннотированных классов в наборе данных. Каждый столбец представляет количество аудиоклипов в поведенческой или акустической категории. Заметен выраженный дисбаланс: несколько высокопредставленных классов (например, сигналы эструса и предвкушения) и множество редких категорий, таких как сигналы обмена ответами или дистресса, отражая естественную асимметрию акустических событий на ферме.
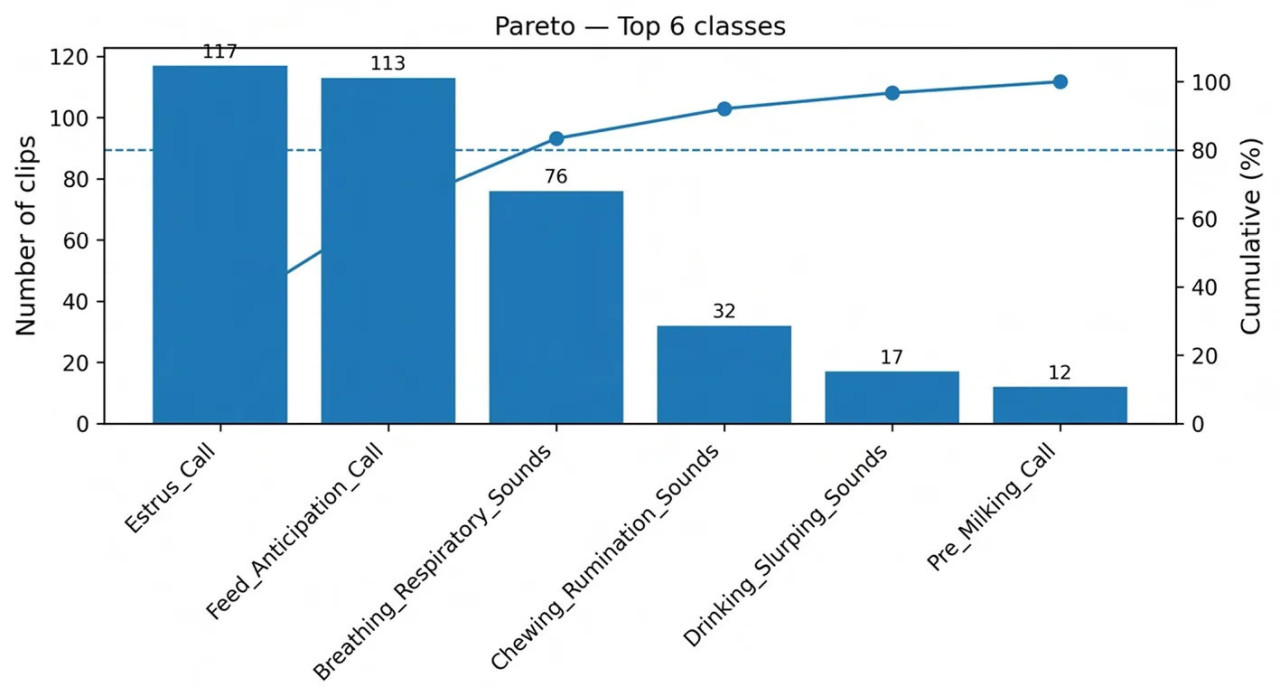
Рисунок 10 Диаграмма Парето шести основных классов вокализаций. Распределение наиболее частых категорий вокализаций в наборе данных, отображённое в виде диаграммы Парето. Столбцы указывают количество клипов на класс, а наложенная линия показывает кумулятивную долю всех клипов. Шесть доминирующих классов вместе составляют большинство записанных образцов, иллюстрируя длиннохвостую природу встречаемости классов и направляя оценку модели к сбалансированному анализу с учётом меньшинств.
Для снижения этого дисбаланса для обучения моделей мы реализовали простую, но явную схему балансировки классов, применяемую только к обучающему набору. Сначала мы определили целевой порог в 81 клип на класс. Это значение близко к размеру среднечастотных классов в исходных данных и обеспечивает практическую верхнюю границу, предотвращающую доминирование нескольких очень распространённых поведений в режиме обучения. Классы с более чем 81 исходным клипом подвергались недостаточной выборке большинства. Для этих высокочастотных классов мы случайным образом выбирали 81 клип без замены для сохранения в обучающем наборе. Например, категории Estrus Call и Feed Anticipation Call были уменьшены с их исходных значений до 81 обучающего клипа каждая. Этот этап понижающей выборки ограничивает влияние чрезвычайно распространённых поведений, сохраняя при этом разнообразный набор образцов.
Классы с менее чем 81 клипом, но как минимум с тремя исходными примерами, затем расширялись посредством аугментации классов меньшинства. Для этих категорий мы генерировали дополнительные клипы с использованием небольшого набора биологически правдоподобных возмущений:
- Растяжение времени [(0,8–1,2×) исходной длительности]
- Сдвиг высоты тона до ±2 полутонов,
- Добавление низкоуровневого гауссовского шума (SNR ≥ 20 дБ) для имитации различных фоновых условий.
- Умеренная регулировка усиления (порядка ±6 дБ) для имитации изменений расстояния до источника сигнала и вокального усилия.
Эти аугментации имитируют естественную вариабельность вокальной продукции и контекста записи, такую как различия в расстоянии до источника сигнала, вокальном усилии или ориентации микрофона. Важно, что параметры аугментации были ограничены биологически правдоподобными диапазонами: сдвиги высоты тона избегали нереалистичных значений F0, тогда как растяжение времени было ограничено ±20% для сохранения временной динамики вокальных событий (Briefer, 2012; Ganchev et al., 2005).
Чрезвычайно редкие классы с менее чем тремя исходными клипами были исключены из обучения модели, но сохранены в метаданных и документации набора данных. Эти поведения (например, некоторые редкие материнские или социальные сигналы) явно помечены как «Dropped» для обучения в наших таблицах, но остаются частью аннотированного корпуса для прозрачности и потенциальной будущей агрегации с дополнительными данными.
После применения недостаточной выборки большинства к очень распространённым классам и аугментации к недостаточно представленным, обучающий набор расширился с 569 до примерно 2900 клипов с гораздо более равномерным распределением по классам. Важно, что эта процедура балансировки применялась только к обучающему разделению. Валидационные и тестовые наборы состоят исключительно из оригинальных, неаугментированных клипов, стратифицированных по классу, так что оценки производительности отражают, как модели обобщаются на реальные записи, а не на синтетические варианты. Таблица 10 представляет количество клипов на класс до и после аугментации, демонстрируя, как аугментация улучшила распределительный баланс.
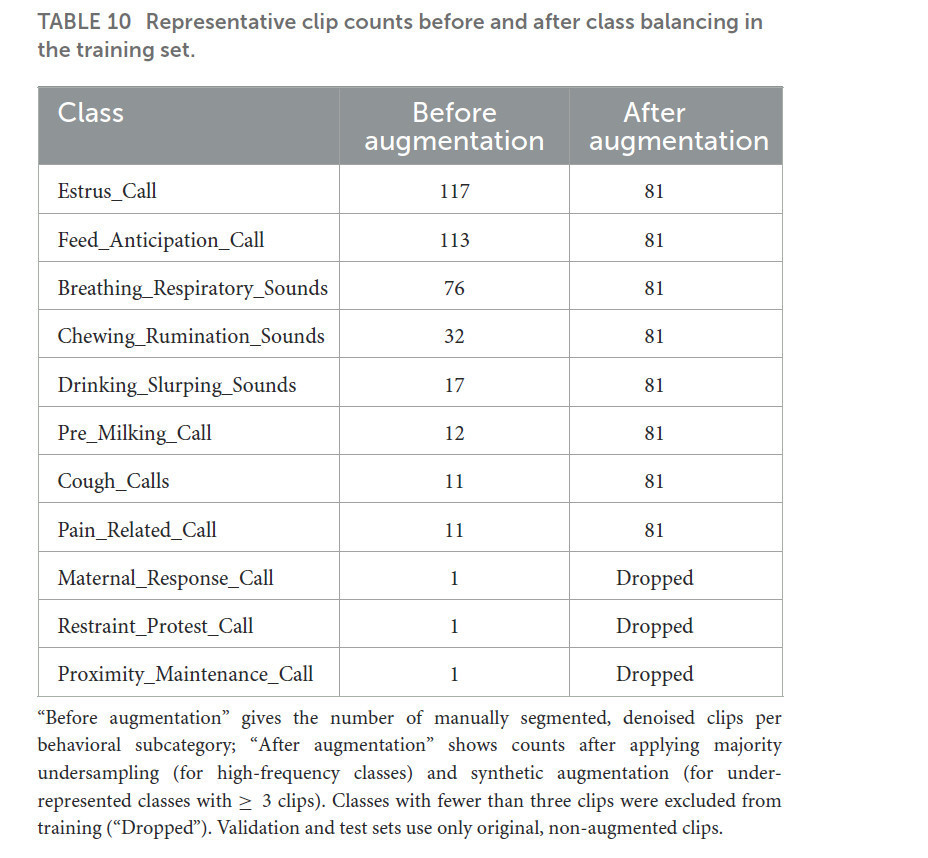
Таблица 10 Репрезентативное количество клипов до и после балансировки классов в обучающем наборе.
«До аугментации» даёт количество вручную сегментированных, шумоподавлённых клипов на поведенческую подкатегорию; «После аугментации» показывает количество после применения недостаточной выборки большинства (для высокочастотных классов) и синтетической аугментации (для недостаточно представленных классов с ≥3 клипами). Классы с менее чем тремя клипами были исключены из обучения («Dropped»). Валидационные и тестовые наборы используют только оригинальные, неаугментированные клипы.
Комбинируя аугментацию и сбалансированную выборку, подход снизил классовое смещение и улучшил способность моделей обобщаться как на частые сигналы (например, предвкушение кормления, респираторные звуки), так и на редкие, но поведенчески значимые сигналы (например, социальное распознавание, разлука). Эта методология отражает лучшую практику в биоакустике животных, где тщательная аугментация помогает фиксировать экологическую вариабельность вокальных сигналов без ущерба для их биологической валидности.
5.5 Предварительный анализ признаков
Для оценки дискриминативной способности извлечённых признаков мы провели исследовательские анализы временных, спектральных и энергетических параметров по всему набору данных. Длительность клипа (Рисунок 11) демонстрировала тяжелохвостое распределение: большинство клипов были короче 20 с, хотя некоторые превышали 200 с; 90-й процентиль составил ~60 с. Это асимметричное распределение отражает поведенческую вариабельность вокализаций крупного рогатого скота, где большинство сигналов являются короткими, контекстно-связанными сигналами, тогда как продолжительные сигналы возникают в контекстах высокого возбуждения, таких как эструс или материнская разлука (Röttgen et al., 2018; Green et al., 2018).
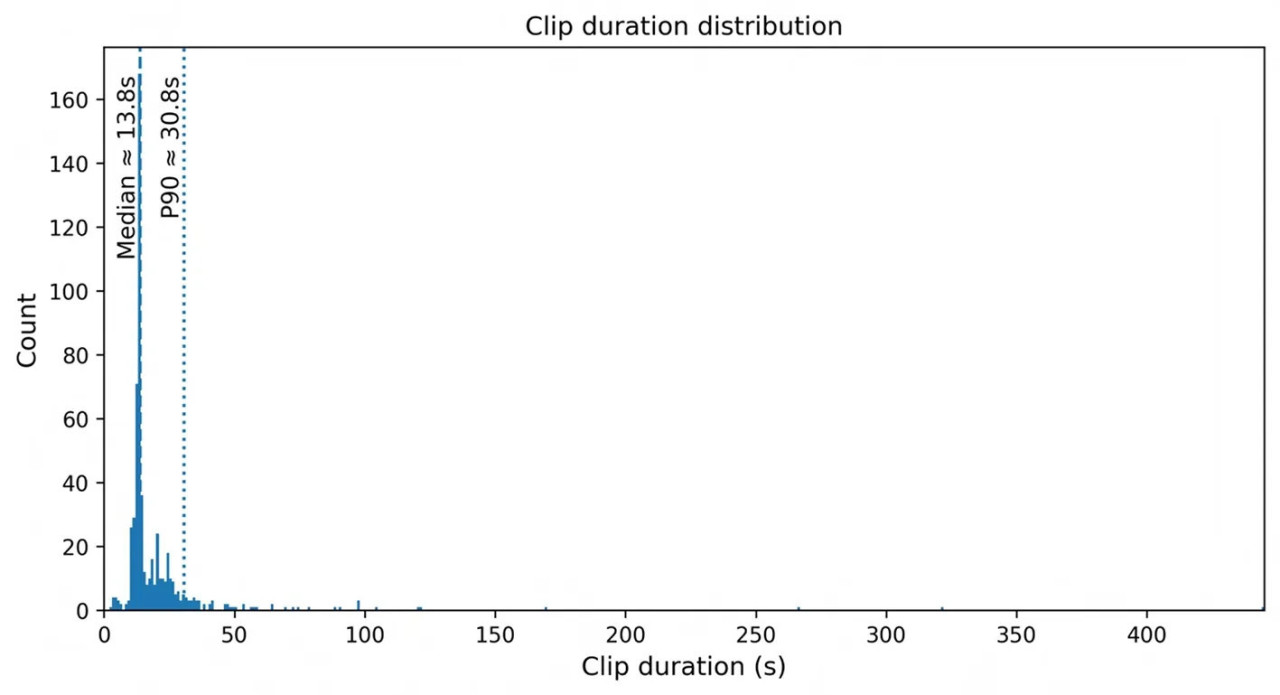
Рисунок 11 Распределение длительности клипов по набору данных. Гистограмма, показывающая временное распределение длин клипов для всех аннотированных вокализаций. Большинство клипов короткие (менее 20 с), тогда как небольшое число превышает одну минуту, создавая тяжелохвостый паттерн. Пунктирные и точечные линии обозначают медианную и 90-процентильную длительности соответственно, подчёркивая вариабельность длины сигнала в различных поведенческих контекстах.
Статистика высоты тона (F0) (Рисунок 13) значительно варьировалась между категориями сигналов. Невокальные звуки, такие как Breathing, Chewing и Mother_Separation_Calls, показывали низкие средние значения F0 (~100 Гц), соответствующие аффилиативным и низкому возбуждению. Напротив, вокализации высокого возбуждения, такие как Estrus Calls, Feed Anticipation Calls, Greeting Calls и Pre-Milking Calls, кластеризовались при существенно более высоких медианных значениях F0 (~415–425 Гц), тогда как Cough Calls достигали ещё более высоких медиан (~440 Гц). Эти паттерны соответствуют предыдущей работе, связывающей повышенную F0 с повышенным возбуждением и дистрессом у крупного рогатого скота и других млекопитающих (Harrison et al., 2018; de la Torre et al., 2015), и качественно соответствуют разделению между классами низкого и высокого возбуждения, видимому на скрипичных диаграммах.
Энергетические и спектральные меры (Рисунки 12, 14) также показали чёткие классоспецифичные сигнатуры. Невокальные экспульсивные звуки, такие как Breathing Respiratory Sounds и Chewing Rumination Sounds, характеризовались очень высокими значениями спектрального центроида (медиана ≈2,4 кГц), отражая их широкополосную, шумную структуру, и относительно высокой RMS-энергией по сравнению со многими гармоническими контактными сигналами. Тональные вокализации, такие как Estrus и Feed Anticipation Calls, а также Pre-Milking Calls, напротив, кластеризовались при гораздо более низких спектральных центроидах (медианы ~370–400 Гц) с более концентрированной спектральной энергией. RMS-энергия дополнительно дифференцировала классы: тихие, низкоинтенсивные события, такие как Pre-Milking и Chewing Rumination Calls, имели тенденцию к низким медианным значениям RMS (~−64 до −60 дБ), тогда как высоковозбуждённые Mating Excitement Calls и High Frequency Distress Calls были среди самых громких сигналов (медианы ~−22,5 дБ и ~−29,9 дБ соответственно), что соответствует повышенному вокальному усилию во время интенсивных аффективных состояний (Meen et al., 2015).
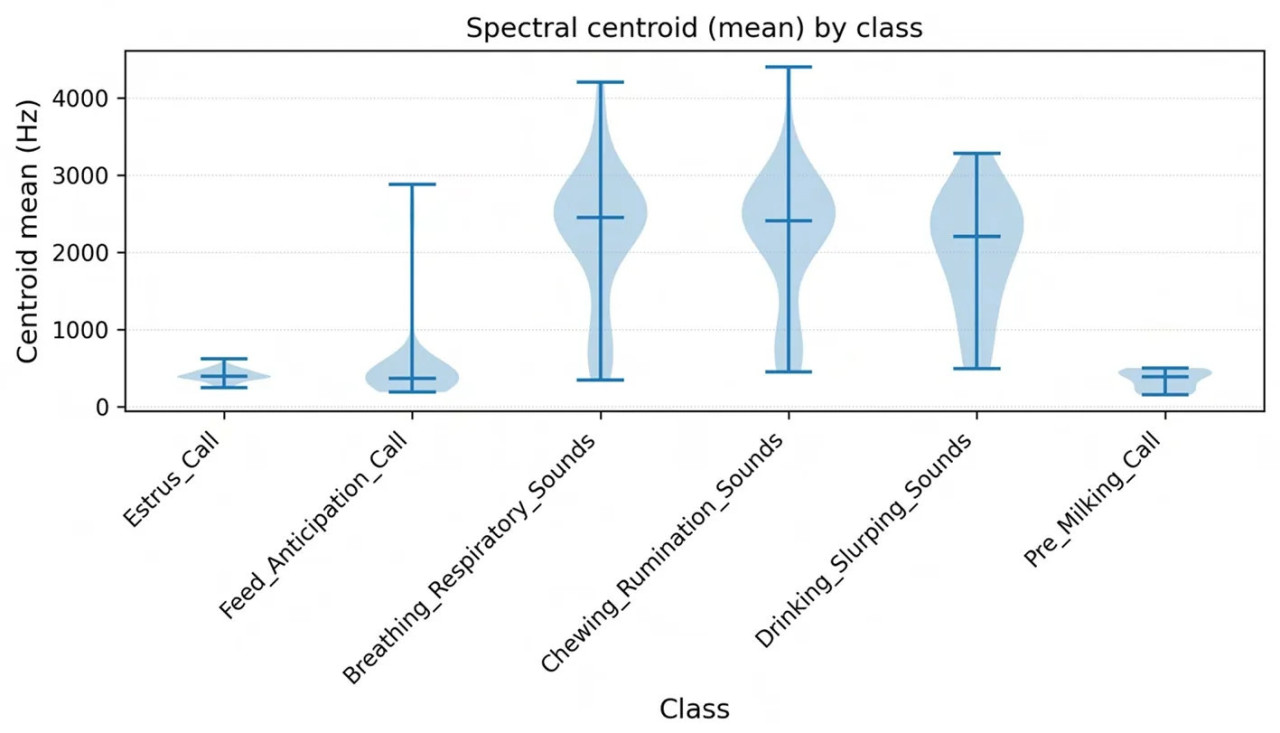
Рисунок 12 Скрипичная диаграмма спектрального центроида (среднее) по классам. Распределение средних значений спектрального центроида для шести основных классов. Спектральный центроид описывает «яркость» звука, при этом более высокие значения указывают на более сильные высокочастотные компоненты. График показывает чёткие классовые различия в спектральной окраске — гармонические мычания кластеризуются при более низких центроидах, тогда как короткие импульсные события (например, кашли, чихания) показывают более широкие, более высокочастотные спектры.
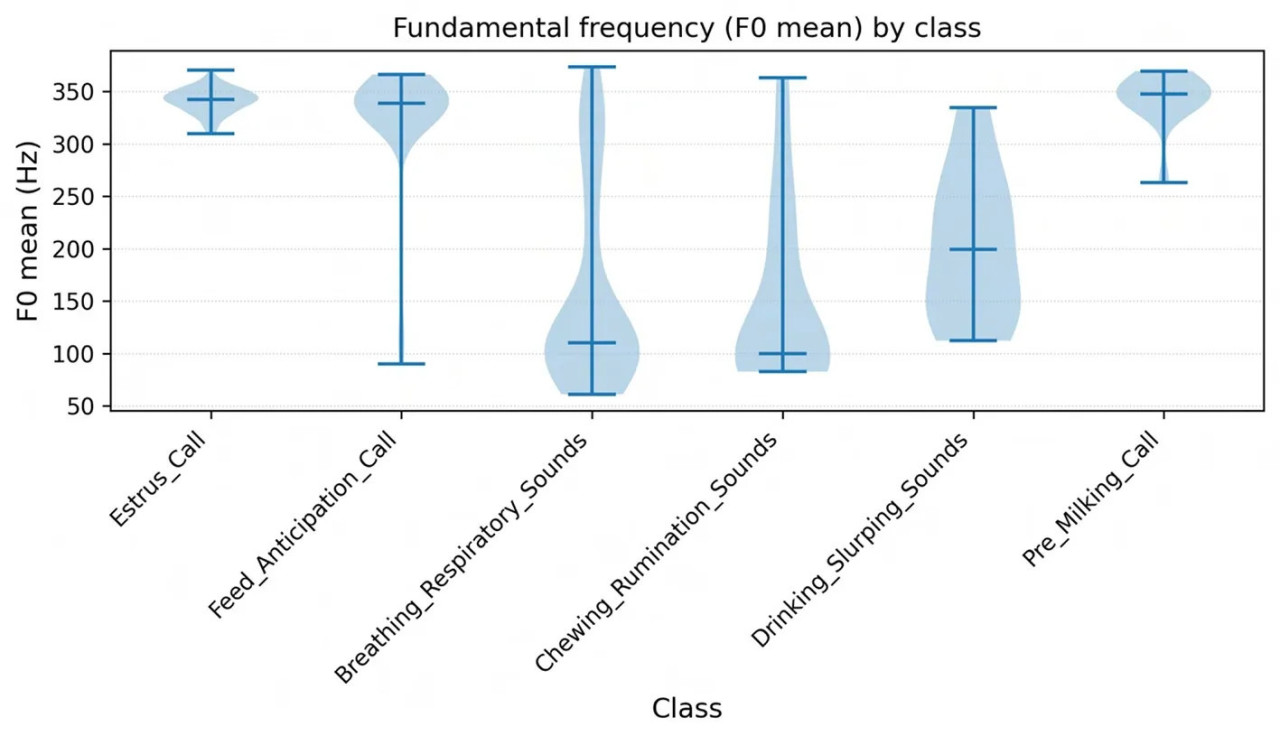
Рисунок 13 Скрипичная диаграмма фундаментальной частоты (среднее F0) по классам. Вариация средней фундаментальной частоты (F0) между шестью основными классами. Каждая скрипичная диаграмма изображает распределение значений F0 внутри класса, с медианой, показанной центральной линией. Более низкочастотные диапазоны соответствуют сигналам низкого возбуждения или контакта, тогда как более высокочастотные сигналы связаны с повышенным возбуждением или дистрессом, что соответствует предыдущим сообщениям в вокальных исследованиях крупного рогатого скота.
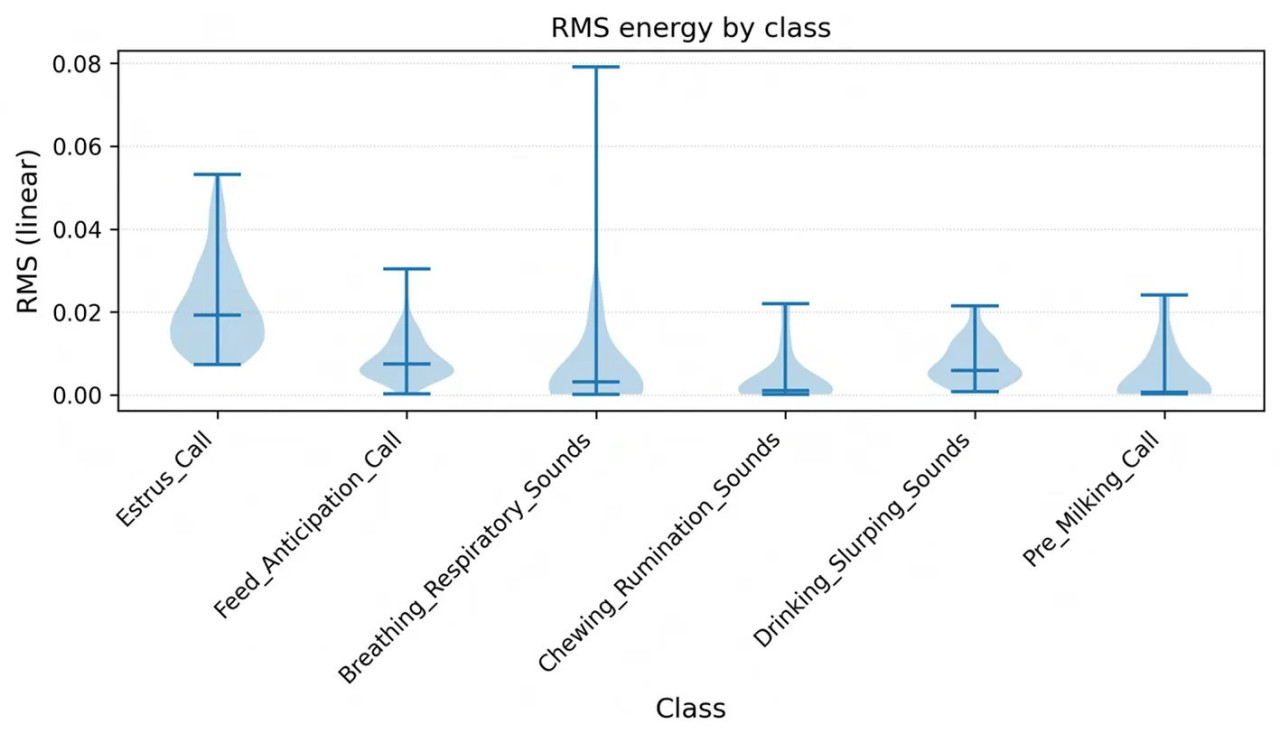
Рисунок 14 Скрипичная диаграмма RMS-энергии по классам. Сравнение средней среднеквадратичной (RMS) энергии среди шести основных классов вокализаций. Мера RMS отражает общую интенсивность сигнала и вокальное усилие. Классы, такие как кашли и отрыжки, демонстрируют более высокие уровни энергии из-за их резкой, широкополосной природы, тогда как гармонические мычания и контактные сигналы показывают более низкие, более стабильные энергетические огибающие.
Для статистической оценки этих паттернов мы применили непараметрические тесты Крускала-Уоллиса к четырём ключевым признакам — длительности клипа, средней F0, спектральному центроиду и RMS-энергии — по двенадцати наиболее представленным классам (n≥10: Breathing Respiratory Sounds, Chewing Rumination Sounds, Cough Calls, Drinking/Slurping Sounds, Estrus Call, Feed Anticipation Call, General Discomfort Call, Greeting Call, High Frequency Distress, Mating Excitement Call, Pain Related Call и Pre-Milking Call). Все четыре признака показали высокозначимые различия между классами (длительность: H = 143,6, p ≈ 3,0 × 10⁻²⁵; средняя F0: H = 220,9, p ≈ 3,4 × 10−41; спектральный центроид: H = 255,5, p ≈ 2,0 × 10−48; RMS-энергия: H = 202,9, p ≈ 1,9 × 10−37), подтверждая, что временные, спектральные и энергетические параметры несут сильную классово-дискриминативную информацию.
Затем мы использовали пост-хок тесты Данна с поправкой Бонферрони для выявления конкретных классовых пар, которые значительно различались. По 66 возможным попарным сравнениям среди двенадцати классов тесты Данна выявили 27, 25, 22 и 18 значимых попарных контрастов для длительности, средней F0, спектрального центроида и RMS-энергии соответственно. Для длительности Drinking/Slurping Sounds (медиана ≈30,0 с) были значительно длиннее, чем краткие высоковозбуждённые Mating Excitement Calls (медиана ≈4,3 с; p_adj ≈1,1×10^(−11)) и Cough Calls (медиана ≈11,8 с; p_adj ≈2,7×10^(−8)), иллюстрируя, как продолжительные эпизоды питья контрастируют с короткими импульсными вокализациями. Для средней F0 низкочастотные Breathing и Chewing Rumination Sounds (медианы ≈118,5 Гц и ≈105,6 Гц) очень сильно отличались от высокочастотных Estrus и Feed Anticipation Calls (медианы ≈417,6 Гц и ≈415,8 Гц), с поправленными по Бонферрони p-значениями, эффективно нулевыми (p_adj <10^(−12)), и медианными различиями, превышающими 290–310 Гц. Спектральный центроид exhibited аналогично выраженные контрасты: невокальные Breathing и Chewing Rumination Sounds (медианы ≈2,4 кГц) имели центроиды более чем на 2 кГц выше, чем тональные Estrus и Feed Anticipation Calls (медианы ≈370–395 Гц; padj ≈0), отражая широкополосный, шумный профиль респираторных и жевательных событий. Наконец, RMS-энергия отличала тихие контактные сигналы от громких высоковозбуждённых сигналов: Mating Excitement Calls (медиана ≈−22,5 дБ) были значительно более интенсивными, чем Chewing Rumination Sounds и Pre-Milking Calls (медианы ≈−59,7 и ≈−64,4 дБ; p_adj <10^(−10)), указывая на заметно более высокое вокальное усилие. Сводка статистики Крускала-Уоллиса и количества значимых пост-хок сравнений Данна по признаку показана в Таблице 11.
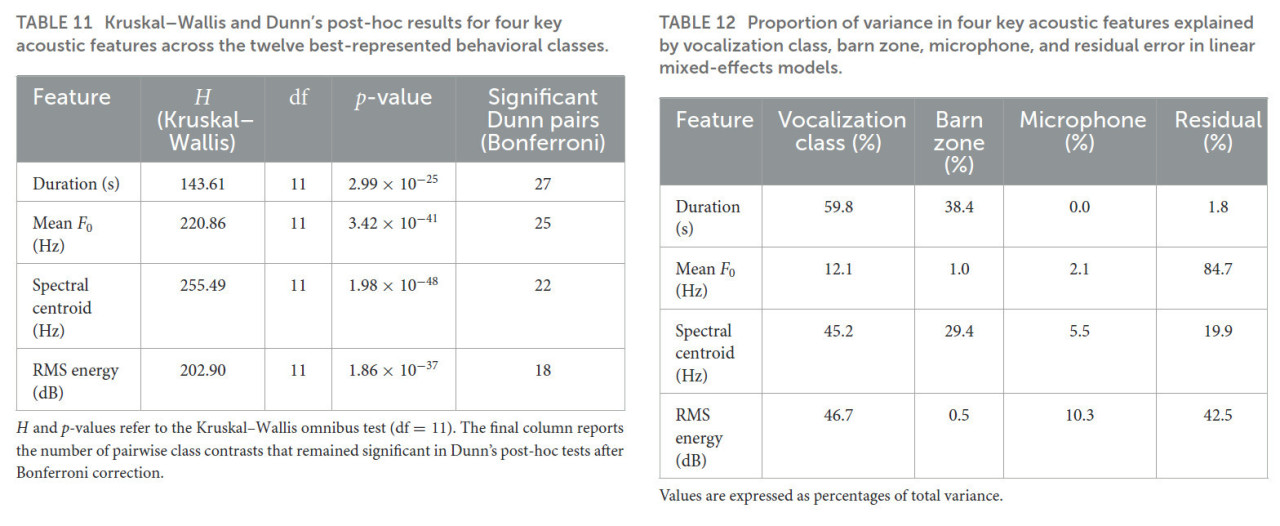
Таблица 11 Результаты Крускала-Уоллиса и пост-хок тестов Данна для четырёх ключевых акустических признаков по двенадцати наиболее представленным поведенческим классам.
Таблица 12 Доля дисперсии в четырёх ключевых акустических признаках, объяснённая классом вокализации, зоной коровника, микрофоном и остаточной ошибкой в линейных смешанных моделях.
H и p-значения относятся к омнибусному тесту Крускала-Уоллиса (df = 11). Последний столбец сообщает количество попарных классовых контрастов, которые остались значимыми в пост-хок тестах Данна после поправки Бонферрони.
Распределения признаков визуализировались с использованием скрипичных диаграмм (Рисунки 12–14), которые подчёркивают эти классоспецифичные сигнатуры: Estrus и Feed Anticipation Calls кластеризуются в более высоких диапазонах F0 и умеренных спектральных центроидах; невокальные респираторные и жевательные звуки занимают отдельную область с очень высокими спектральными центроидами и переменной энергией; а короткие высокоэнергетические события, такие как кашли и сигналы дистресса, показывают как повышенную RMS, так и отличительные спектральные профили. В совокупности эти результаты тестов Крускала-Уоллиса и Данна показывают, что все четыре ключевых признака сильно и систематически варьируются между поведенческими классами, при этом средняя F0 и спектральный центроид обеспечивают особенно сильную дискриминацию, и примерно одна треть — две пятых всех классовых пар различаются значительно по каждому признаку даже при строгой поправке Бонферрони.
5.6 Линейные смешанные модели и компоненты дисперсии
Для количественной оценки того, какая часть вариации акустических признаков attributable к классу вокализации по сравнению с контекстом записи, мы подобрали линейные смешанные модели (LMM) для четырёх ключевых признаков: длительности клипа, средней F0, спектрального центроида и RMS-энергии. Для каждого признака мы использовали те же двенадцать наиболее представленных поведенческих классов, что и в анализе Крускала-Уоллиса, и указали класс вокализации как фиксированный эффект, со случайными пересечениями для фермы, зоны коровника и идентичности микрофона. Эта структура позволила нам разделить дисперсию на компоненты, связанные с поведением источника сигнала (класс), различиями уровня фермы, локальной средой коровника, размещением микрофона и остаточной (внутриклассовой) вариацией.
Тесты отношения правдоподобия, сравнивающие полные модели (включая фиксированный эффект класса) с сокращёнными моделями только со случайными эффектами, показали, что класс вокализации значительно улучшил соответствие модели для всех четырёх признаков. Статистики отношения правдоподобия были большими и высокозначимыми (длительность: LR ≈ 177,4, df = 27, p ≈ 4,6 × 10⁻²⁴; средняя F0: LR ≈ 63,6, df = 27, p ≈ 8,7 × 10⁻⁵; спектральный центроид: LR ≈ 789,8, df = 27, p ≈ 5,4 × 10−149; RMS-энергия: LR ≈ 332,0, df = 27, p ≈ 2,9 × 10−54), подтверждая, что класс вокализации объясняет существенную часть вариации сверх эффектов фермы, зоны коровника и микрофона. Полные графики компонентов дисперсии для всех четырёх линейных смешанных моделей представлены в Дополнительных рисунках S3–S6.
Оценки компонентов дисперсии (Таблица 12) показали, что длительность и спектральный центроид особенно структурированы классом вокализации и средой коровника. Для длительности класс вокализации объяснял ~59,8% дисперсии, при этом ещё 38,4% attributable к зоне коровника и только 1,8% к остаточной вариации. Спектральный центроид показал аналогичный паттерн: 45,2% дисперсии объяснялось классом и 29,4% зоной коровника, по сравнению с 5,5% микрофоном и 19,9% остаточной. Эти результаты указывают на то, что временные и широкие спектральные признаки формы несут сильные классоспецифичные сигнатуры, которые остаются надёжными после учёта контекста записи, хотя локальная среда коровника всё ещё вносит значимый вклад.
Значения выражены в процентах от общей дисперсии.
Напротив, средняя F0 exhibited гораздо больший остаточный компонент: только 12,1% её дисперсии объяснялось классом вокализации, с 1,0% от зоны коровника и 2,1% от микрофона, тогда как 84,7% оставались как внутриклассовая остаточная дисперсия. Это свидетельствует о том, что F0 подвержена существенной индивидуальной или моментной вариации, которая не фиксируется нашими текущими метаданными, даже хотя эффект класса всё ещё статистически значим. Для RMS-энергии как класс вокализации, так и оборудование записи играли важные роли: 46,7% дисперсии attributable к классу, 10,3% к микрофону и 42,5% к остаточной вариации, подчёркивая, что амплитудные признаки по своей природе чувствительны к размещению микрофона и локальному шуму, но всё ещё сохраняют сильный поведенческий сигнал. В целом, результаты LMM подтверждают непараметрические тесты, показывая, что ключевые акустические признаки содержат существенную классово-дискриминативную информацию, при этом явно количественно оценивая вклады фермы, среды коровника и размещения микрофона в наблюдаемую вариабельность.
5.7 Анализ главных компонент акустического пространства признаков
Для визуализации структуры в многомерном пространстве признаков мы применили анализ главных компонент (PCA) к 24 стандартизированным акустическим признакам, извлечённым из всех клипов. Первая главная компонента (PC1) объясняла 29,6% дисперсии, вторая (PC2) — 16,0%, а третья (PC3) — 14,1%, так что первые три PC вместе фиксировали 59,7% общей дисперсии. PC 4 и 5 accounted for дополнительные 9,7% и 7,7% соответственно, при этом каждая последующая компонента объясняла <5% (график каменистой осыпи в Дополнительном рисунке S7), указывая на чёткий излом после первых 3–5 компонент.
Изучение нагрузок PCA показало, что PC1 была доминирована мерами спектральной формы и шумности, с высокими положительными нагрузками для спектрального центроида, спектральной полосы пропускания, спектрального среза и частоты переходов через ноль, а также первой форманты (f1). PC2 наиболее сильно нагружалась на MFCC1, среднее и стандартное отклонение RMS-энергии, отношение voiced и SNR, фиксируя градиент амплитуды/voicing. PC4 была в первую очередь связана со статистикой F0 (среднее, минимальное и максимальное), указывая на то, что вариация фундаментальной частоты концентрируется на отдельной оси от широкой спектральной формы и энергии.
Распределение оценок PC1–PC2 выявляет структурированный акустический ландшафт: клипы образуют широкие кластеры вдоль градиента от широкополосных, шумных событий с высоким спектральным центроидом и частотой переходов через ноль (высокая PC1) к более тональным сигналам с концентрированной низкочастотной энергией (низкая PC1), и вдоль второго градиента от низкоинтенсивных, низких MFCC1 звуков к высокоэнергетическим, сильно voiced событиям (высокая PC2). Этот многомерный взгляд соответствует одномерным и смешанным модельным анализам, подтверждая, что временные, спектрально-форменные и энергетические признаки совместно организуют вокализации крупного рогатого скота в низкоразмерном пространстве, которое может быть использовано нижестоящими классификаторами. В совокупности эти этапы создания набора данных и многоуровневые статистические анализы обеспечивают хорошо охарактеризованный акустический эталон для вокализаций молочного скота, который мы теперь интерпретируем в более широком контексте точного благополучия животноводства и существующей литературы по биоакустике в Обсуждении.
6 Обсуждение
6.1 Значимость для ИИ и больших данных
Набор данных, представленный в этом исследовании, непосредственно способствует продвижению ИИ и подходов, управляемых данными, в биоакустике животных. В отличие от предыдущих коллекций, ограниченных по размеру или охвату, этот корпус предлагает как масштаб, так и разнообразие, предоставляя 569 аннотированных клипов (расширенных до ~2900 после аугментации для моделирования) по 48 поведенческим классам. Такая широта crucial для применений машинного обучения, где производительность модели зависит от exposure как к частым, так и к редким событиям. Включая сигналы высокого возбуждения (например, эструс, дистресс), аффилиативные сигналы (например, контакт, материнские) и невокальные звуки (например, дыхание, отрыжки), набор данных позволяет алгоритмам изучать акустические сигнатуры широкого поведенческого спектра, а не узкого подмножества условий.
Не менее важен экологический реализм набора данных. Модели машинного обучения, обученные на чистых, бесшумных записях, часто терпят неудачу при развёртывании в реальных средах коровника. Сохраняя подлинный фоновый шум и перекрывающиеся акустические события, этот ресурс гарантирует, что вычислительные модели, разработанные на его основе, устойчивы к проблемам развёртывания. Многомикрофонная и мультимодальная установка добавляет дополнительную глубину, позволяя исследователям изучать кросс-валидацию по типам оборудования и зонам или выравнивать акустические признаки с поведенческим контекстом, зафиксированным на видео. Этот дизайн делает набор данных ценным не только для контролируемой классификации, но и для самообучающегося обучения, обучения представлений и трансферного обучения — областях, где крупные гетерогенные наборы данных особенно эффективны. Тесты Крускала-Уоллиса, пост-хок тесты Данна и линейные смешанные модели вместе показывают, что ключевые акустические признаки (длительность, F0, спектральный центроид, RMS) систематически варьируются между поведенческими классами и не доминируются артефактами фермы, зоны коровника или микрофона. Компоненты дисперсии указывают, что класс объясняет существенную долю вариабельности, при этом экологические и аппаратные эффекты вносят меньшие, вторичные компоненты.
Наконец, интеграция метаданных, соответствующих FAIR, и стандартизированных акустических признаков (Praat, librosa, openSMILE) гарантирует, что набор данных совместим с более широкими экосистемами исследований ИИ. Исследователи могут напрямую применять установленные конвейеры для отбора признаков, снижения размерности или подготовки входных данных для глубокого обучения, снижая барьеры для воспроизводимости. Поскольку конвейер relies на общие время-частотные признаки и метаданные FAIR, та же структура может быть расширена на другие виды животноводства (например, овцы, козы, свиньи) и интегрирована в кросс-видовые модели ИИ для благополучия сельскохозяйственных животных. Таким образом, набор данных преодолевает разрыв между исследованиями поведения животных и современными методологиями ИИ, прочно помещая анализ вокализаций крупного рогатого скота в область науки о больших данных.
6.2 Ограничения и проблемы
Хотя набор данных является комплексным, он не лишён ограничений. Наиболее заметная проблема заключается в дисбалансе классов: небольшое число категорий, таких как эструс и предвкушение кормления, доминируют в корпусе, тогда как редкие события, такие как сигналы конкуренции за питьё или сигналы реакции на новую среду, представлены лишь несколькими клипами. Это длиннохвостое распределение отражает поведенческую экологию, но усложняет обучение модели, поскольку классификаторы могут переобучаться на частых категориях, пренебрегая редкими, но этологически значимыми. Стратегии аугментации могут смягчить это смещение, но они не могут полностью заменить естественно встречающиеся данные.
Другое ограничение возникает из субъективности ручного аннотирования. Хотя использовались строгие протоколы и кросс-валидация несколькими аннотаторами, некоторые типы сигналов по своей природе неоднозначны, особенно когда перекрываются с фоновым шумом или возникают в сложных социальных контекстах. Метки, такие как «фрустрация» или «дистресс», основаны на поведенческом выводе, который, хотя и основан на этологии, не может зафиксировать внутренние эмоциональные состояния с абсолютной уверенностью. Это подчёркивает необходимость будущих наборов данных интегрировать мультимодальную физиологическую или сенсорную валидацию для укрепления надёжности меток. Ручная сегментация и аннотирование, хотя и обеспечивают высокую точность, остаются трудоёмкими и могут ограничивать масштабируемость без полуавтоматических подходов. Будущая работа, интегрирующая автоматические детекторы или рамки активного обучения, могла бы облегчить это узкое место, сохраняя точность аннотирования.
Сама акустическая среда также создавала проблемы. Коммерческие коровники характеризуются постоянным механическим шумом и перекрывающейся вокальной активностью, которые, хотя и существенны для экологического реализма, снижают чёткость сигнала. Даже после тщательного шумоподавления и фильтрации остаточные помехи остаются в некоторых клипах. Хотя этот реализм повышает ценность развёртывания, он также увеличивает вычислительные требования для сегментации, извлечения признаков и классификации. Исследователи, применяющие продвинутые модели к этому набору данных, должны поэтому осознавать, что шумоустойчивость остаётся открытой проблемой.
Ключевое ограничение заключается в том, что мы не оценивали расстояние источник-микрофон для каждого клипа. Микрофоны размещались в экологически реалистичных позициях в зонах коровника, но расстояние по клипу и пути распространения не измерялись. В результате признаки, связанные с амплитудой, сочетают усилие источника сигнала, расстояние и локальную акустику; будущая работа с использованием видео-трекинга или технологии локализации могла бы явно моделировать расстояние и лучше разделять эффекты уровня источника и среды.
Аналогично, факторы уровня коровы, такие как возраст, паритет и стадия лактации, не были полностью закодированы в публичных метаданных, и мы не проводили систематических анализов с стратификацией по паритету или возрасту. Наши результаты поэтому отражают агрегированные паттерны по смешанным группам тёлок и многорожавших коров. Будущие исследования должны включать стандартизированные дескрипторы уровня животного, чтобы разделить поведенческие, физиологические эффекты и эффекты жизненной истории на структуру вокализаций.
Наконец, хотя набор данных велик по стандартам биоакустики животноводства, он остаётся скромным по сравнению с эталонами больших данных в других областях ИИ, таких как распознавание речи или компьютерное зрение. Расширение временного охвата (например, по сезонам, фермам и породам) и увеличение размера выборки дополнительно укрепило бы его обобщаемость и позволило бы обучать более сложные архитектуры глубокого обучения.
6.3 Перспективы и будущие направления
Текущий набор данных закладывает основу, но также открывает несколько путей для расширения и методологических инноваций. Одно перспективное направление — включение лонгитюдных записей, фиксирующих вокальное поведение в разные сезоны, практики управления и стадии жизни. Расширение охвата за пределы трёх ферм и включение разнообразных пород улучшило бы репрезентативность и позволило бы проводить сравнительные исследования в генетических и экологических контекстах.
Другая возможность заключается в мультимодальной интеграции. Хотя этот набор данных уже связывает аудио с видео и ручными аннотациями, будущая работа могла бы выравнивать вокальные данные с физиологическими маркерами (например, частота сердечных сокращений, уровни кортизола, датчики руминации) для обеспечения многослойных доказательств состояний благополучия. Такая интеграция снизила бы неоднозначность поведенческих меток и укрепила бы интерпретируемость акустических индикаторов.
С вычислительной точки зрения набор данных особенно хорошо подходит для изучения новых парадигм ИИ. Крупные гетерогенные акустические корпусы ценны для обучения самообучающихся моделей, которые изучают представления общего назначения перед тонкой настройкой для конкретных задач, таких как обнаружение эструса, мониторинг благополучия или идентификация личности. Аналогично, трансферное обучение от вокализаций крупного рогатого скота к родственным видам — или от моделей человеческой речи к контекстам животноводства — представляет возможности для кросс-доменных инноваций.
Наконец, набор данных подчёркивает важность открытых, стандартизированных ресурсов в сельскохозяйственном ИИ. Придерживаясь принципов FAIR, эта работа вносит вклад в растущее движение к воспроизводимым, управляемым сообществом наборам данных в науке о животных. Установление общих эталонов для биоакустики животноводства, аналогичных ImageNet или LibriSpeech в исследованиях компьютерного зрения и речи, ускорило бы прогресс, позволяя систематические сравнения моделей и способствуя совместной разработке. Ресурс, представленный здесь, может служить ранним шагом в этом направлении, поощряя как масштабирование будущих наборов данных, так и совершенствование аналитических инструментов, адаптированных к вокальному поведению животных. Эти соображения подготавливают почву для нашего заключения, где мы суммируем вклады набора данных и его потенциальную роль в продвижении цифрового сельского хозяйства и приложений больших данных в науке о животных.
7 Заключение
В этой работе мы представили один из наиболее комплексных наборов данных вокализаций крупного рогатого скота, собранных на сегодняшний день, интегрируя 569 кураторских оригинальных клипов по 48 поведенческим классам, записанных в подлинных средах коровника. Комбинируя многомикрофонную аудиозапись, комплементарные видео-наблюдения и подробные этологически ориентированные аннотации, набор данных обеспечивает экологически валидный ресурс для продвижения как исследований поведения животных, так и вычислительного моделирования. Этапы предобработки гарантировали, что клипы были шумоподавлены, сегментированы и сопряжены с богатыми метаданными, тогда как конвейеры извлечения признаков генерировали интерпретируемые акустические дескрипторы, согласованные с наукой о благополучии.
Набор данных вносит три ключевых вклада. Во-первых, он расширяет эмпирическую основу для изучения вокального поведения крупного рогатого скота за пределами ограничений контролируемых лабораторных записей, охватывая акустическую сложность реальных фермерских условий. Во-вторых, он обеспечивает воспроизводимую, соответствующую FAIR структуру с прозрачными метаданными и определениями признаков, позиционируя биоакустику крупного рогатого скота в более широкой экосистеме исследований больших данных. В-третьих, он предлагает эталонный корпус для разработки и тестирования методов ИИ, от контролируемой классификации до новых подходов, таких как самообучающееся обучение представлений.
В совокупности эти вклады закладывают основу для неинвазивных, управляемых данными подходов к мониторингу благополучия животных и точному управлению животноводством. Хотя проблемы остаются в масштабировании, балансе классов и мультимодальной интеграции, этот набор данных представляет критический шаг к созданию надёжных, воспроизводимых ресурсов, необходимых для предоставления крупному рогатому скоту «цифрового голоса» в будущих системах умного фермерства.
Дополнительные материалы
Дополнительные материалы к этой статье можно найти онлайн по адресу: https://www.frontiersin.org/articles/10.3389/fdata.2025.1723155/full#supplementary-material
Kate M and Neethirajan S (2026) Big data approaches to bovine bioacoustics: a FAIR-compliant dataset and scalable ML framework for precision livestock welfare. Front. Big Data 8:1723155. doi: 10.3389/fdata.2025.1723155
Перевод статьи «Big data approaches to bovine bioacoustics: a FAIR-compliant dataset and scalable ML framework for precision livestock welfare» авторов Kate M and Neethirajan S, оригинал доступен по ссылке. Лицензия: CC BY. Изменения: переведено на русский язык
Фото: Designed by Freepik




Комментарии (0)